یادگیری تقویتی چیست و چگونه هوش مصنوعی از پاداش و خطا یاد میگیرد؛ بررسی نکات و جزئیات مهم
هوش مصنوعی در سالهای اخیر به یکی از مهمترین نوآوریهای فناوری تبدیل شده است و یکی از روشهای اصلی یادگیری در این حوزه، یادگیری تقویتی است. این روش که بر اساس تعامل سیستم با محیط و دریافت بازخورد از آن بنا شده، به مدلهای هوش مصنوعی امکان میدهد تا با تجربه و خطا بهینهسازی کنند. اما یادگیری تقویتی دقیقاً چیست؟ چگونه کار میکند؟ و چه تفاوتهایی با روشهای دیگر یادگیری ماشین دارد؟ در این مقاله به بررسی جزئیات این روش، مکانیزمهای آن، کاربردهای عملی و نکات مهمی که باید در مورد آن بدانید، میپردازیم.
یادگیری تقویتی: تعریف و اصول پایه
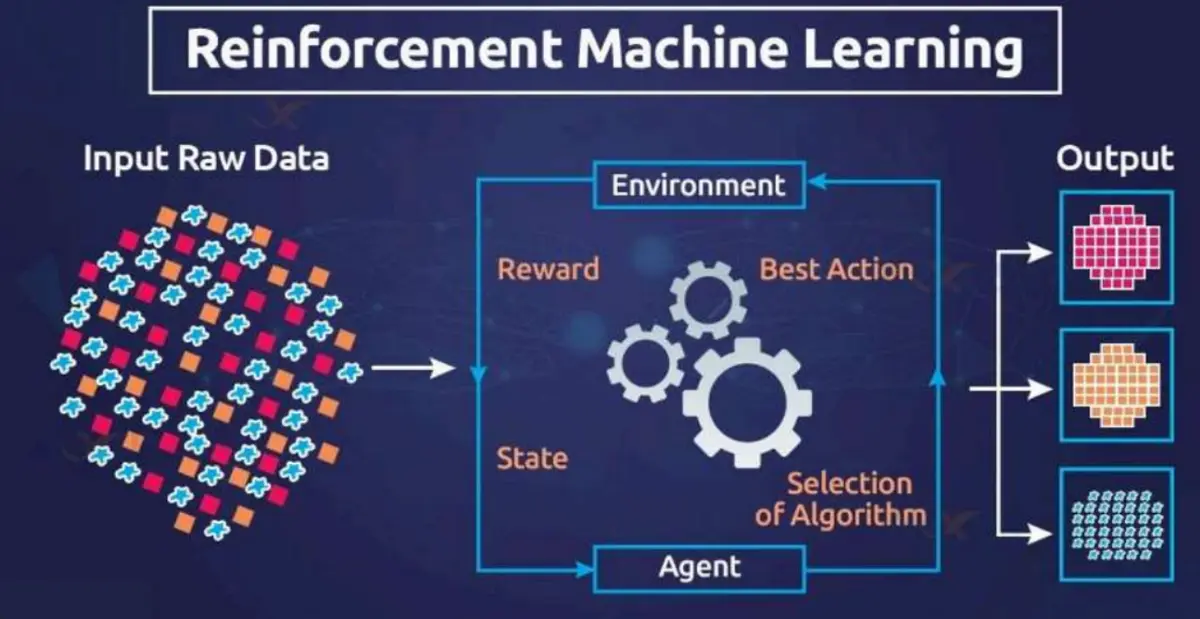
یادگیری تقویتی (Reinforcement Learning) یک زیرشاخه از یادگیری ماشین است که در آن یک عامل (agent) با محیط تعامل میکند و از طریق دریافت پاداش یا جریمه، سعی میکند رفتار خود را بهینه کند. در این روش، عامل هیچ دادهای پیشفرض ندارد و باید از طریق تجربه و تعامل با محیط، سیاستهای بهینهای را یاد بگیرد.
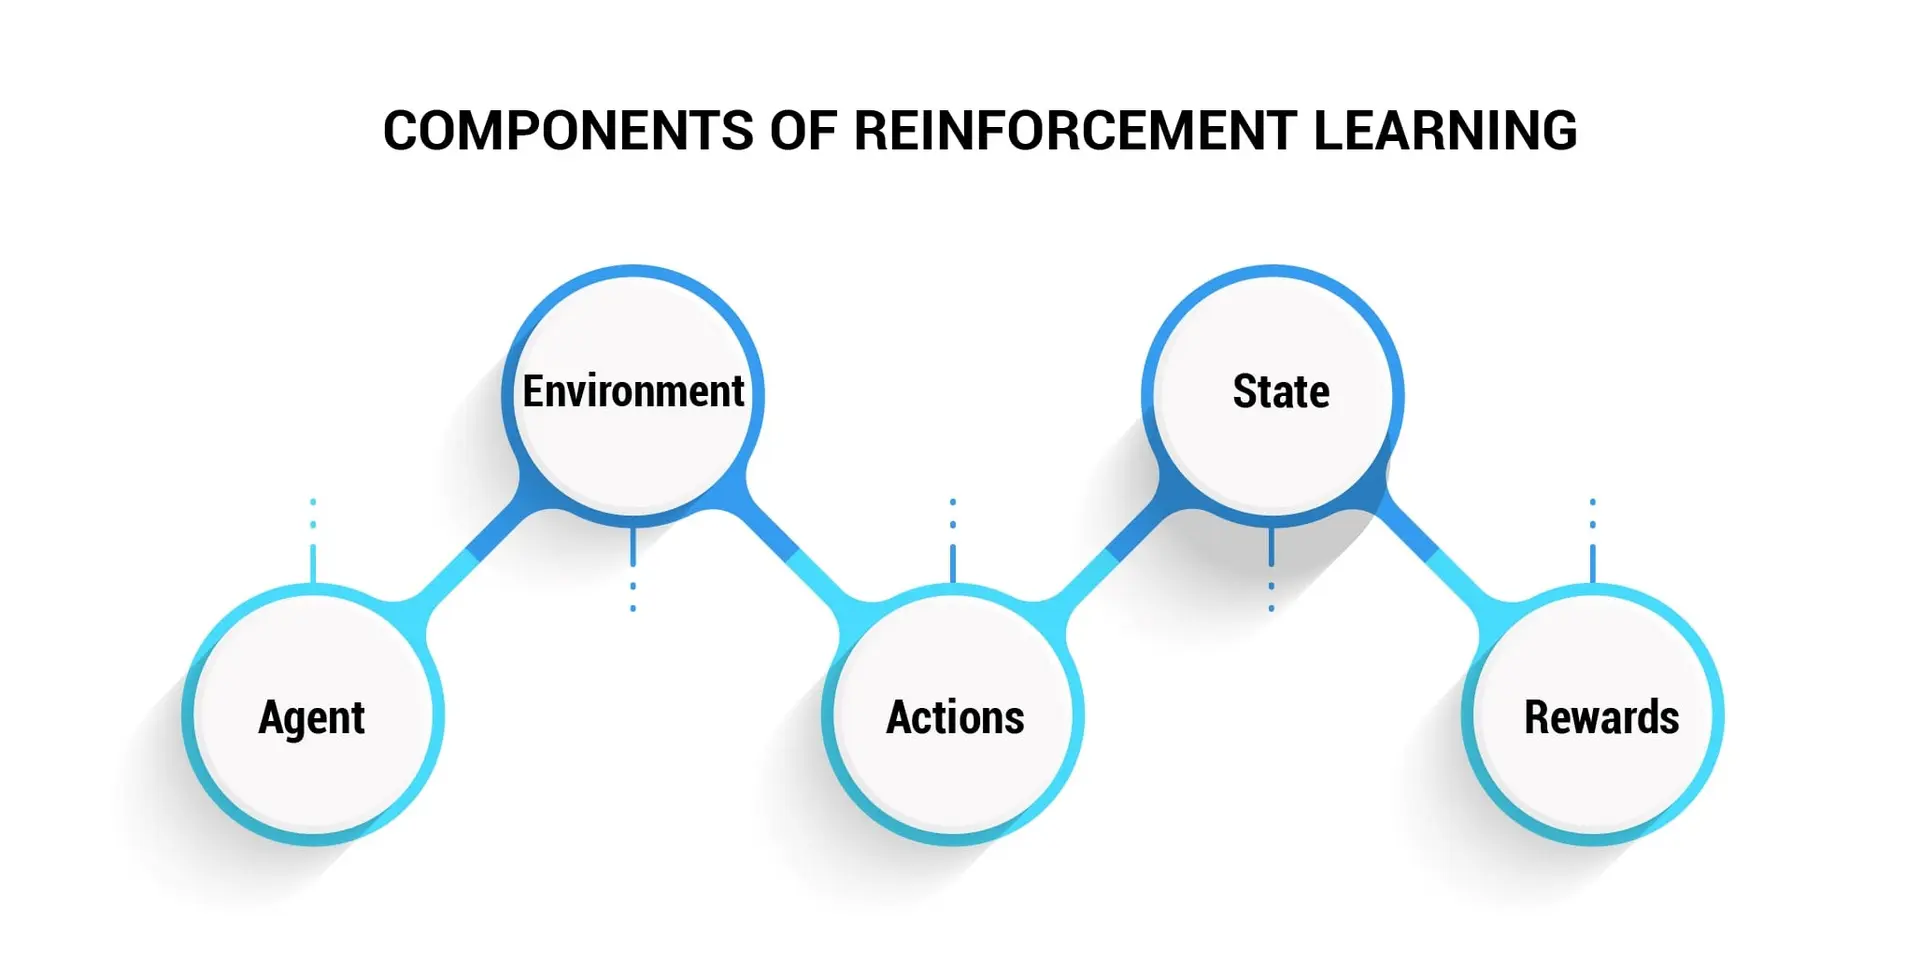
مفاهیم کلیدی یادگیری تقویتی شامل موارد زیر است:
- عامل (Agent): سیستم یا الگوریتمی که تصمیمات را میگیرد و با محیط تعامل دارد.
- محیط (Environment): فضای خارجی که عامل در آن عمل میکند و بازخورد میدهد.
- حالت (State): وضعیت فعلی سیستم یا محیط که عامل باید بر اساس آن تصمیم بگیرد.
- عمل (Action): اقداماتی که عامل میتواند در هر حالت انجام دهد.
- پاداش (Reward): بازخوردی که عامل از محیط دریافت میکند و نشاندهنده موفقیت یا شکست عمل است.
- سیاست (Policy): استراتژیای که عامل برای انتخاب عمل در هر حالت استفاده میکند.
هدف اصلی عامل در یادگیری تقویتی، یادگیری سیاستی است که مجموع پاداشهای دریافتی را در طول زمان به حداکثر برساند. این روش به ویژه در شرایطی که دادههای برچسبدار (labeled data) در دسترس نیست، بسیار مؤثر عمل میکند.
چگونه هوش مصنوعی از پاداش و خطا یاد میگیرد؟
در یادگیری تقویتی، عامل از طریق تجربه و دریافت بازخورد یاد میگیرد. این فرایند به صورت زیر انجام میشود:
۱. عامل در یک حالت خاص قرار میگیرد و یک عمل را انتخاب میکند.
۲. محیط بر اساس عمل انجام شده، حالت جدیدی را تعیین میکند و پاداشی را به عامل میدهد.
۳. عامل با استفاده از این پاداش، سیاست خود را به روز میرساند تا در آینده عمل بهتری انجام دهد.
۴. این چرخه تکرار میشود و عامل با تجربه، سیاست بهینهتری را یاد میگیرد.
یکی از روشهای مهم در یادگیری تقویتی، استفاده از الگوریتمهای مانند Q-Learning یا Deep Reinforcement Learning است. در این الگوریتمها، عامل یک تابع ارزش (value function) یا یک شبکه عصبی عمیق را آموزش میدهد تا بهترین عمل را در هر حالت انتخاب کند.
برای مثال، در بازیهای ویدیویی، عامل میتواند از طریق انجام بازی و دریافت امتیاز (که نوعی پاداش است)، یاد بگیرد که چگونه بهترین حرکت را در هر حالت انجام دهد. این روش در توسعه بازیهای هوشمند، رباتیک و حتی سیستمهای خودران کاربرد دارد.
تفاوت یادگیری تقویتی با روشهای دیگر یادگیری ماشین
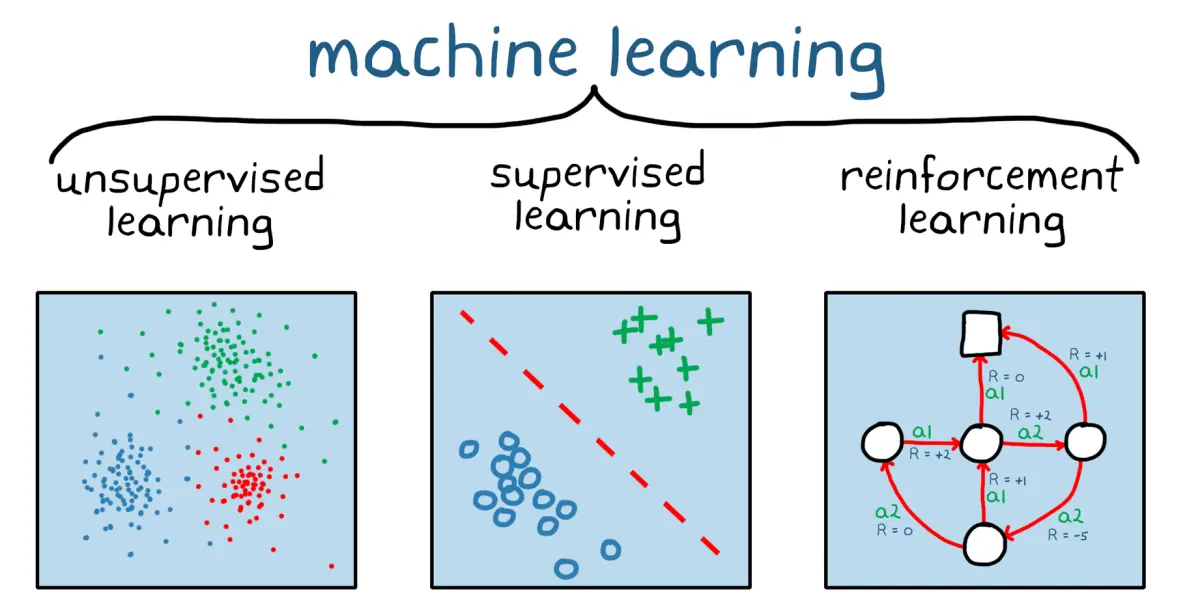
یادگیری تقویتی با روشهای دیگر یادگیری ماشین مانند یادگیری با نظارت (Supervised Learning) و یادگیری بدون نظارت (Unsupervised Learning) تفاوتهای اساسی دارد. در زیر به برخی از این تفاوتها اشاره میکنیم:
- یادگیری با نظارت: در این روش، مدل با دادههای برچسبدار آموزش میبیند و هدف پیشبینی خروجی بر اساس ورودی است. برای مثال، تشخیص تصویر یا پیشبینی قیمت سهام.
- یادگیری بدون نظارت: در این روش، مدل از دادههای بدون برچسب استفاده میکند و هدف پیدا کردن الگوهای پنهان در دادهها است. برای مثال، خوشهبندی یا کاهش بعد.
- یادگیری تقویتی: در این روش، عامل از طریق تعامل با محیط و دریافت پاداش یاد میگیرد و هیچ دادهای پیشفرض ندارد. هدف بهینهسازی رفتار برای دریافت پاداش بیشتر است.
یادگیری تقویتی به ویژه در شرایطی که دادههای برچسبدار در دسترس نیست یا محیط بسیار پیچیده است، بسیار مؤثر عمل میکند. برای مثال، در رباتیک، عامل باید از طریق تجربه یاد بگیرد که چگونه در محیطهای نامشخص حرکت کند.
کاربردهای عملی یادگیری تقویتی
یادگیری تقویتی در بسیاری از حوزهها کاربرد دارد و به عنوان یکی از روشهای پیشرفته در توسعه سیستمهای هوشمند شناخته میشود. برخی از کاربردهای مهم آن عبارتند از:
- بازیهای ویدیویی: الگوریتمهای یادگیری تقویتی مانند AlphaGo که توسط DeepMind توسعه یافته، توانستهاند در بازیهای پیچیده مانند گو و شطرنج به سطح حرفهای برسند.
- رباتیک: رباتها میتوانند از طریق یادگیری تقویتی یاد بگیرند که چگونه در محیطهای مختلف حرکت کنند و وظایف خود را به بهترین شکل انجام دهند.
- سیستمهای خودران: خودروهای خودران از یادگیری تقویتی برای یادگیری رفتارهای ایمن در ترافیک استفاده میکنند.
- پیشبینی مالی: در بازارهای مالی، الگوریتمهای یادگیری تقویتی میتوانند برای بهینهسازی استراتژیهای سرمایهگذاری استفاده شوند.
- روباتیک صنعتی: در خطوط تولید، رباتها میتوانند از یادگیری تقویتی برای بهینهسازی عملکرد و کاهش خطا استفاده کنند.
یکی از چالشهای اصلی یادگیری تقویتی، نیاز به محیطهایی است که بتوانند پاداشهای مناسب را ارائه دهند و همچنین زمان و منابع زیادی برای آموزش نیاز است. با این حال، پیشرفتهای اخیر در زمینه یادگیری عمیق و تقویت آن با یادگیری تقویتی، این روش را به یکی از مهمترین ابزارهای توسعه هوش مصنوعی تبدیل کرده است.
نکات مهم در یادگیری تقویتی
برای استفاده مؤثر از یادگیری تقویتی، باید به چند نکته مهم توجه کرد:
- تعریف صحیح پاداش: پاداش باید به گونهای طراحی شود که رفتارهای مطلوب را تشویق کند و رفتارهای نامطلوب را جریمه کند.
- انتخاب الگوریتم مناسب: انتخاب الگوریتم مناسب مانند Q-Learning، Deep Q-Network یا Policy Gradient بسیار مهم است و باید بر اساس پیچیدگی محیط و نیازهای پروژه انجام شود.
- مدلسازی صحیح محیط: محیط باید به گونهای طراحی شود که عامل بتواند به صورت مؤثر با آن تعامل داشته باشد.
- بهینهسازی سیاست: سیاست عامل باید به گونهای باشد که بتواند در شرایط مختلف بهینه عمل کند.
- ارزیابی عملکرد: باید روشهای مناسب برای ارزیابی عملکرد عامل در محیط تعریف کرد تا بتواند بهبود یابد.
یکی از چالشهای اصلی یادگیری تقویتی، نیاز به دادههای فراوان و زمان طولانی برای آموزش است. با این حال، با استفاده از روشهای پیشرفته مانند یادگیری انتقالی (Transfer Learning) و تقویت یادگیری با دادههای محدود، میتوان این چالشها را کاهش داد.
چالشها و محدودیتهای یادگیری تقویتی
با وجود مزایای فراوان، یادگیری تقویتی با چالشهایی نیز همراه است. برخی از این چالشها عبارتند از:
- نیاز به محیطهای شبیهسازی شده: در بسیاری از موارد، نیاز به محیطهایی با شبیهسازی دقیق وجود دارد که توسعه آنها زمانبر و هزینهبر است.
- پایداری و تعمیمپذیری: الگوریتمهای یادگیری تقویتی ممکن است در محیطهای جدید یا تغییرات کوچک در محیط، عملکرد ضعیفی داشته باشند.
- زمان آموزش: آموزش الگوریتمهای یادگیری تقویتی ممکن است زمان زیادی ببرد و نیاز به منابع محاسباتی زیادی داشته باشد.
- تعریف پاداش: طراحی پاداش مناسب برای محیطهای پیچیده میتواند بسیار دشوار باشد.
با این حال، با پیشرفتهای اخیر در زمینه یادگیری عمیق و استفاده از شبکههای عصبی، بسیاری از این چالشها کاهش یافته و کاربردهای جدیدی برای یادگیری تقویتی ایجاد شده است.