مسمومسازی داده چیست و چگونه آموزش مدل هوش مصنوعی را مختل میکند؛ راهنمای کامل و کاربردی
در دنیای امروزی که هوش مصنوعی به یکی از مهمترین ابزارهای تصمیمگیری و تحلیل تبدیل شده است، امنیت و کیفیت دادهها نقش حیاتی ایفا میکنند. یکی از بزرگترین تهدیدهایی که مدلهای هوش مصنوعی با آن مواجه هستند، مسمومسازی داده (Data Poisoning) است. این روش مخرب، که به عنوان یکی از انواع حملات سایبری به دادهها شناخته میشود، میتواند عملکرد مدلهای یادگیری ماشین را به شدت تحت تأثیر قرار دهد و حتی به نتایج کاملاً نادرست و خطرناک منجر شود. اما مسمومسازی داده دقیقاً چیست؟ چگونه عمل میکند و چه راههایی برای مقابله با آن وجود دارد؟ در این راهنمای کامل، به بررسی این موضوع میپردازیم و راهکارهای کاربردی برای شناسایی و پیشگیری از آن را ارائه میدهیم.
مسمومسازی داده چیست؟
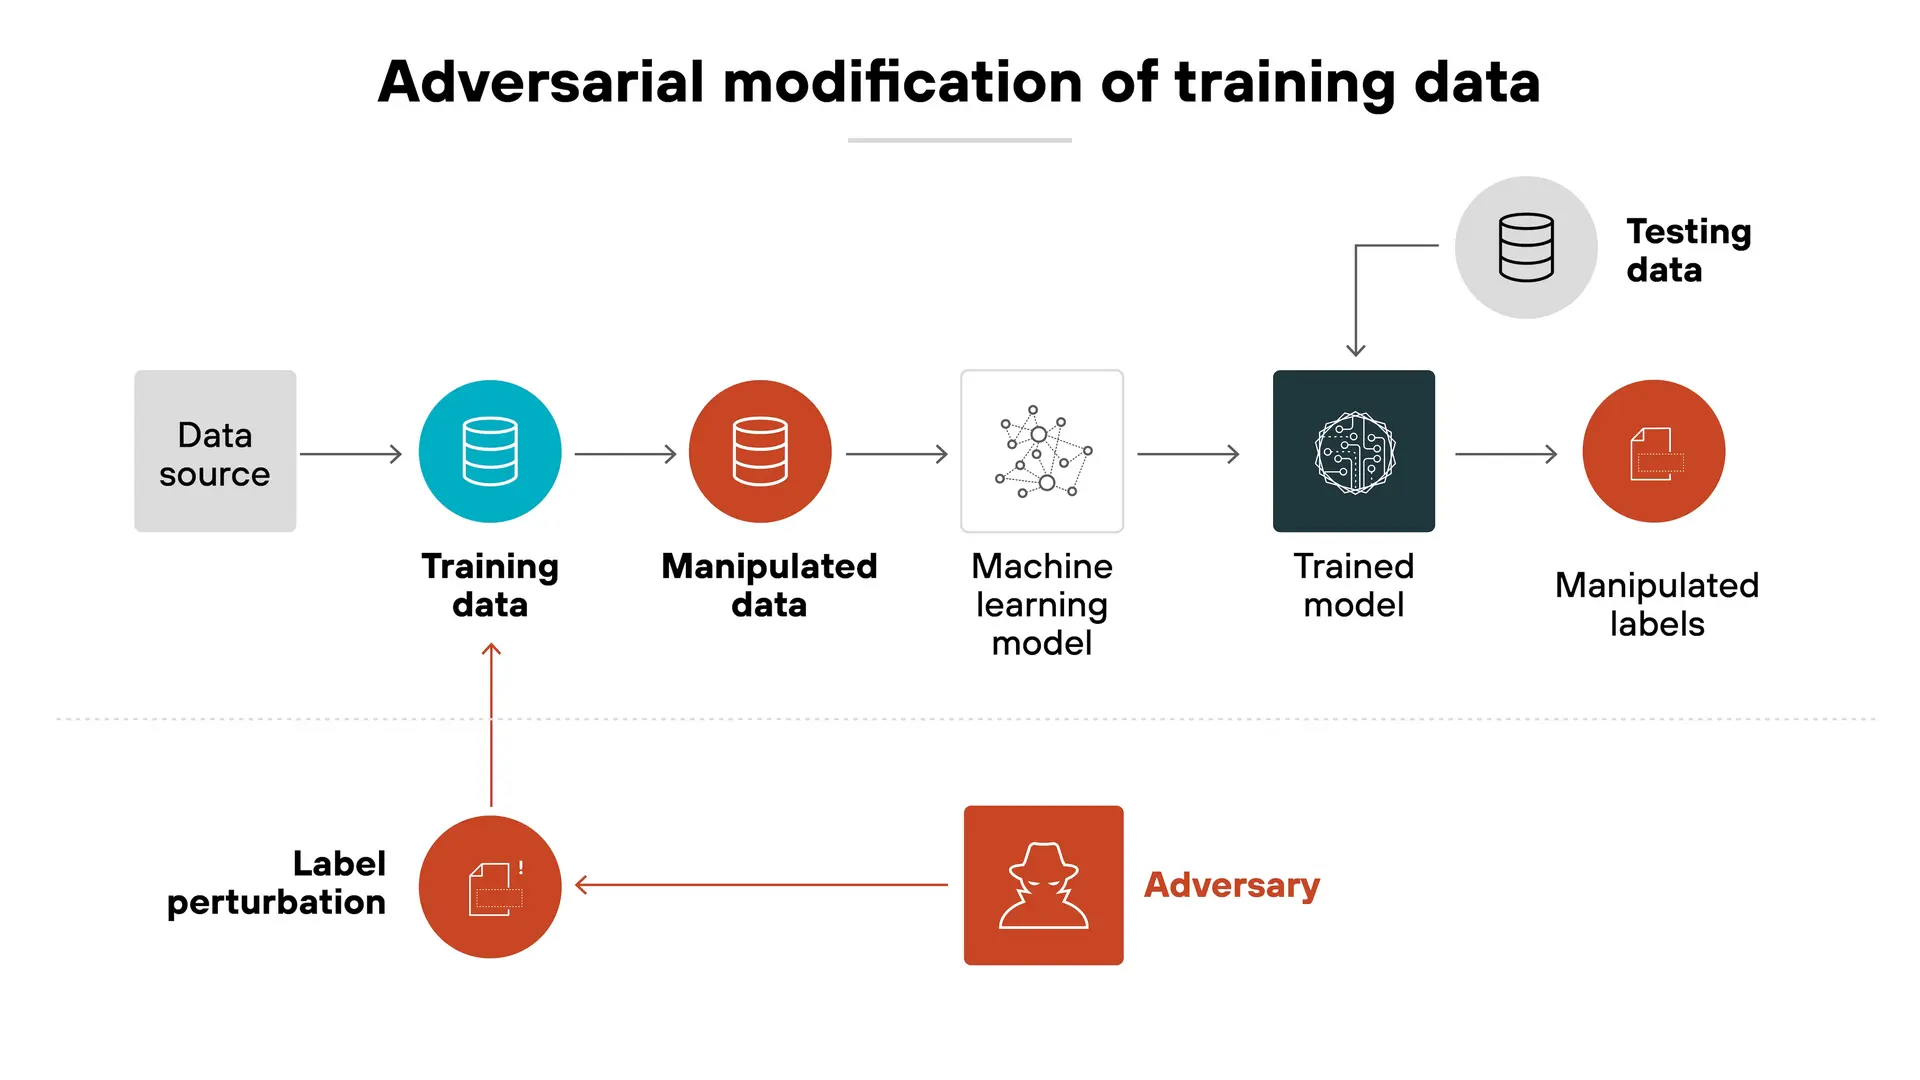
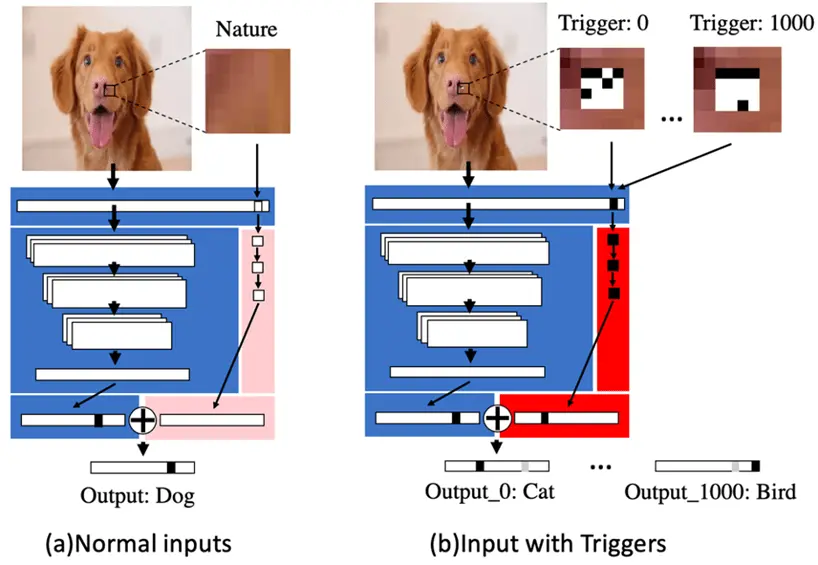
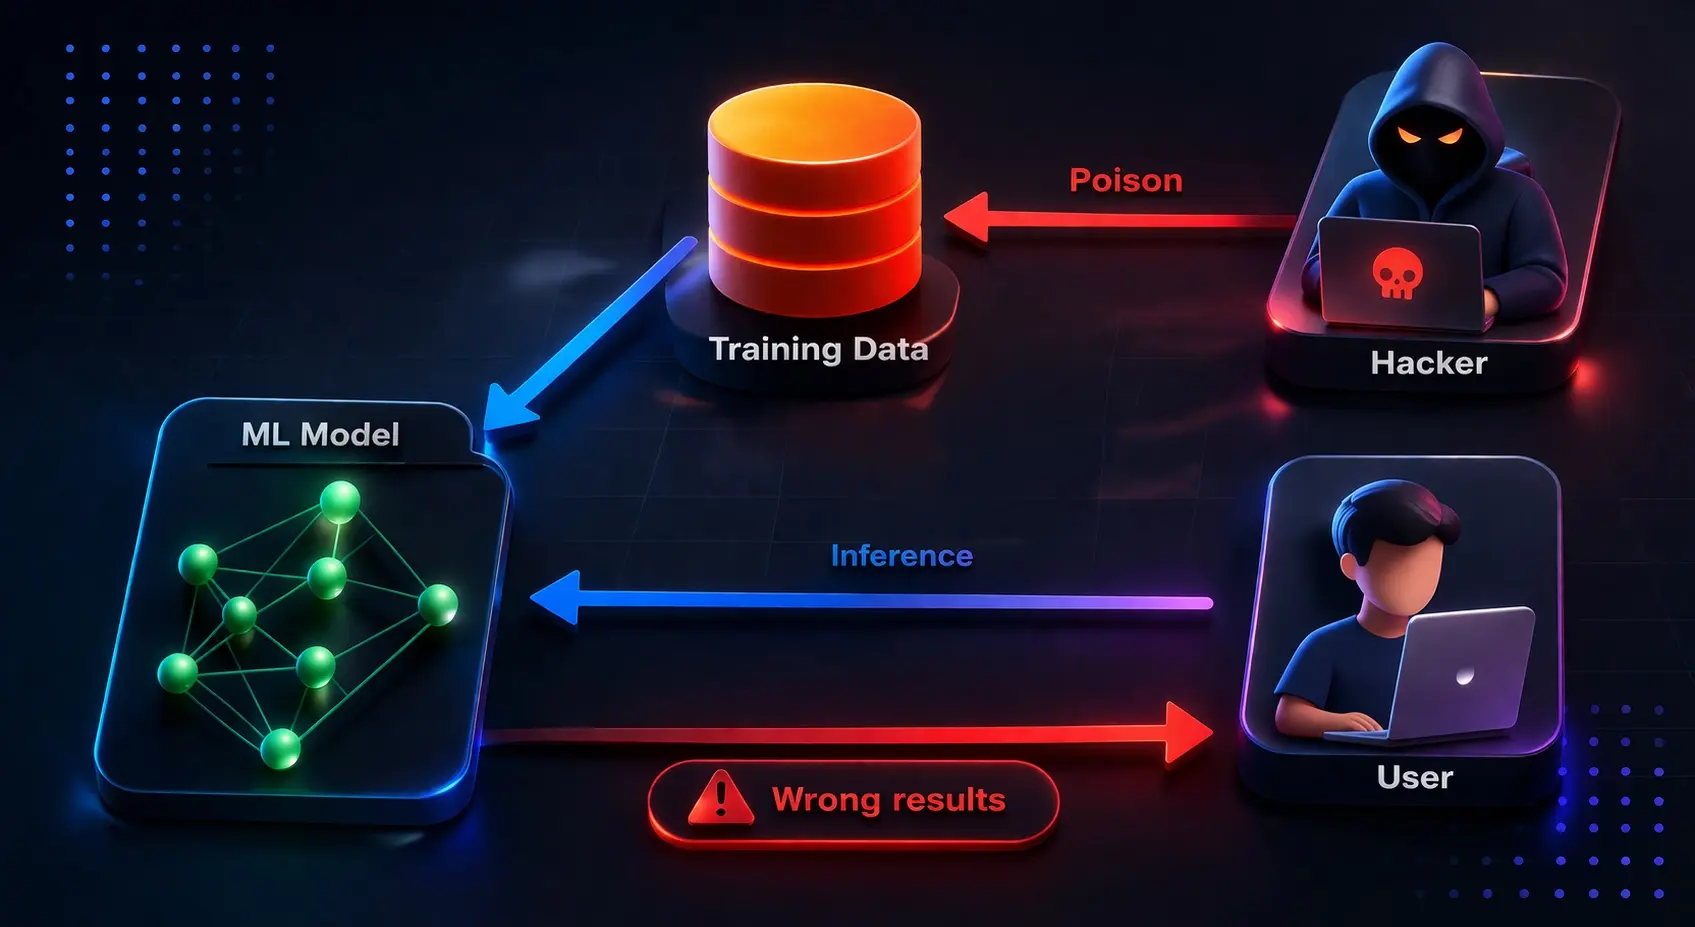
مسمومسازی داده یک روش عمدی آلودگی دادهها است که توسط مهاجم یا فردی با نیت خرابکارانه انجام میشود. در این روش، دادههای آلوده یا نادرست به مجموعه دادههای آموزشی مدل هوش مصنوعی اضافه میشوند تا الگوریتم یادگیری را به سمت نتایج نادرست هدایت کنند. این روش میتواند به صورت مستقیم یا غیرمستقیم انجام شود و در هر دو صورت، عملکرد مدل را مختل میکند.
به عنوان مثال، تصور کنید یک مدل تشخیص چهره برای شناسایی افراد در یک سیستم امنیتی استفاده میشود. اگر مهاجم دادههای نادرستی از چهرههای مشابه با افراد خاص را به مجموعه دادههای آموزشی اضافه کند، مدل ممکن است در شناسایی صحیح آن افراد دچار اشتباه شود و حتی به جای تشخیص فرد مورد نظر، فرد دیگری را شناسایی کند.
چگونه مسمومسازی داده آموزش مدل هوش مصنوعی را مختل میکند؟
مسمومسازی داده میتواند از طریق چندین مکانیسم مختلف به عملکرد مدل آسیب برساند:
- تغییر در الگوریتم یادگیری: دادههای آلوده میتوانند باعث شوند مدل به جای یادگیری الگوهای واقعی، الگوهای نادرست را یاد بگیرد. این موضوع میتواند منجر به کاهش دقت و افزایش خطا در پیشبینیهای مدل شود.
- افزایش بیاعتمادی: اگر مدل در تشخیص دادههای واقعی دچار مشکل شود، کاربران ممکن است به نتایج آن اعتماد نکنند و در نهایت از استفاده از آن خودداری کنند.
- تغییر در تصمیمگیری: در سیستمهای حساس مانند تشخیص بیماریها یا تشخیص چهره، مسمومسازی داده میتواند منجر به تصمیمگیریهای نادرست و حتی خطرناک شود.
- افزایش هزینهها: برای اصلاح مدل آلوده، نیاز به هزینههای اضافی برای جمعآوری دادههای جدید و بازآموزی مدل وجود دارد.
این روش میتواند به صورت مستقیم یا غیرمستقیم انجام شود. در مسمومسازی مستقیم، دادههای کاملاً نادرست به مجموعه داده اضافه میشوند، در حالی که در مسمومسازی غیرمستقیم، دادههای واقعی با تغییرات جزئی یا اضافه کردن نویز، به گونهای تغییر مییابند که مدل از یادگیری صحیح بازمیماند.
چگونه میتوان مسمومسازی داده را شناسایی کرد؟
شناسایی مسمومسازی داده یکی از چالشهای اصلی در امنیت دادهها است. با این حال، با استفاده از روشهای مناسب، میتوان به شناسایی این نوع حملات پرداخت:
- تحلیل دادهها: بررسی دادههای آموزشی برای شناسایی الگوهای غیرعادی یا دادههای خارج از دامنه (Outliers) میتواند کمککننده باشد.
- استفاده از روشهای تشخیص انحراف: الگوریتمهای تشخیص انحراف میتوانند دادههای غیرمعمول را شناسایی کنند که ممکن است نشانهای از مسمومسازی باشند.
- بررسی دقت مدل: اگر دقت مدل بهطور ناگهانی کاهش یابد، ممکن است نشانهای از مسمومسازی داده باشد.
- استفاده از روشهای رمزنگاری و امضا دیجیتال: برای اطمینان از اصالت دادهها، میتوان از روشهای امنیتی مانند امضا دیجیتال استفاده کرد.
همچنین، استفاده از دادههای آزمایشی و بررسی عملکرد مدل در شرایط مختلف میتواند کمک کند تا دادههای آلوده شناسایی شوند.
راهکارهای پیشگیری از مسمومسازی داده
برای جلوگیری از مسمومسازی داده و حفظ امنیت مدلهای هوش مصنوعی، میتوان از راهکارهای زیر استفاده کرد:
- استفاده از دادههای با کیفیت: جمعآوری دادههای با کیفیت و از منابع معتبر میتواند خطر مسمومسازی را کاهش دهد.
- استفاده از روشهای تصفیه داده: روشهای تصفیه داده مانند فیلتر کردن دادههای غیرمعمول یا استفاده از الگوریتمهای تشخیص نویز میتواند کمککننده باشد.
- امنیت در جمعآوری داده: استفاده از روشهای امنیتی مانند کنترل دسترسی و رمزنگاری در هنگام جمعآوری دادهها میتواند از آلودگی داده جلوگیری کند.
- بازبینی مداوم: بررسی مداوم دادهها و عملکرد مدل میتواند به شناسایی زودهنگام مسمومسازی کمک کند.
- استفاده از مدلهای مقاوم: طراحی مدلهایی که در برابر دادههای آلوده مقاوم هستند، میتواند از تأثیرات مسمومسازی داده کاسته شود.
همچنین، آموزش کارکنان و افزایش آگاهی در مورد خطرات مسمومسازی داده میتواند نقش مهمی در پیشگیری از این نوع حملات ایفا کند.
مسمومسازی داده در دنیای واقعی
مسمومسازی داده در دنیای واقعی میتواند تأثیرات جدی داشته باشد. برای مثال، در سیستمهای تشخیص خودکار بیماریها، اگر دادههای آلوده به مجموعه دادههای آموزشی اضافه شوند، مدل ممکن است تشخیص نادرستی انجام دهد و منجر به درمان نادرست بیمار شود. همچنین، در سیستمهای مالی، مسمومسازی داده میتواند باعث تصمیمگیریهای نادرست در قرضدهی یا تشخیص فرآیندهای مشکوک شود.
یکی از نمونههای معروف مسمومسازی داده، حمله به سیستمهای توصیهگر است. در این سیستمها، دادههای آلوده میتوانند باعث شوند مدل محصولات یا خدمات نادرست را به کاربران پیشنهاد دهد و منجر به کاهش رضایت مشتری شود.
چگونه میتوان مدلهای هوش مصنوعی را در برابر مسمومسازی داده مقاوم کرد؟
برای افزایش مقاومت مدلهای هوش مصنوعی در برابر مسمومسازی داده، میتوان از روشهای زیر استفاده کرد:
- استفاده از دادههای متنوع: استفاده از دادههای متنوع از منابع مختلف میتواند مدل را در برابر دادههای آلوده مقاومتر کند.
- استفاده از روشهای یادگیری نیمهنظری: این روشها میتوانند با استفاده از دادههای کمتر، مدلهای دقیقتری ایجاد کنند و در برابر دادههای آلوده مقاومتر باشند.
- استفاده از روشهای تشخیص دادههای آلوده: الگوریتمهای تشخیص دادههای آلوده میتوانند قبل از استفاده از دادهها، آنها را بررسی کنند و دادههای مشکوک را حذف یا تصحیح کنند.
- استفاده از روشهای رمزنگاری: رمزنگاری دادهها میتواند از تغییرات غیرمجاز جلوگیری کند و دادهها را در برابر مسمومسازی محافظت کند.
همچنین، استفاده از روشهای ارزیابی مداوم عملکرد مدل میتواند کمک کند تا در صورت بروز مشکلی، به سرعت آن را شناسایی و اصلاح کرد.
نکات پایانی
مسمومسازی داده یکی از بزرگترین تهدیدهای امنیتی در دنیای هوش مصنوعی است که میتواند عملکرد مدلها را به شدت تحت تأثیر قرار دهد. برای مقابله با این تهدید، نیاز به استفاده از روشهای پیشگیری و شناسایی مناسب است. همچنین، افزایش آگاهی در مورد این موضوع و آموزش کارکنان میتواند نقش مهمی در کاهش خطرات مربوطه ایفا کند.
در دنیای امروزی که دادهها به یکی از ارزشمندترین داراییها تبدیل شدهاند، حفظ امنیت و کیفیت دادهها باید یکی از اولویتهای اصلی سازمانها باشد. با استفاده از راهکارهای مناسب، میتوان از تأثیرات مخرب مسمومسازی داده جلوگیری کرد و مدلهای هوش مصنوعی را برای استفادههای مختلف آماده کرد.
برای اطلاعات بیشتر در مورد امنیت دادهها و روشهای پیشگیری از مسمومسازی، میتوانید به مقالات مرتبط در دیلی 24 مراجعه کنید.