مدلهای هوش مصنوعی چگونه آموزش میبینند و دادههای آموزشی از کجا میآیند؛ نکات کاربردی و اشتباهات رایج
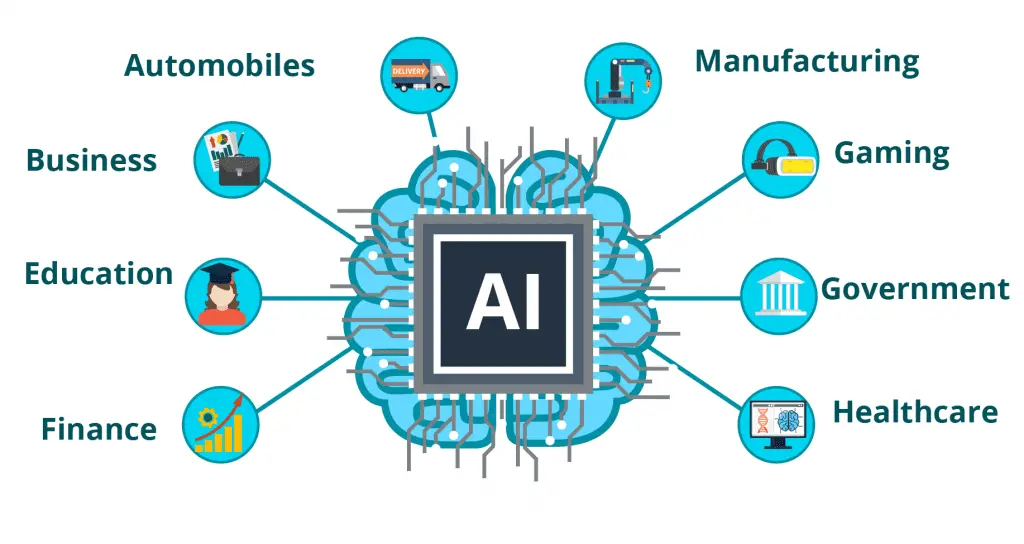
هوش مصنوعی در سالهای اخیر به یکی از مهمترین فناوریهای جهان تبدیل شده است. سیستمهای هوش مصنوعی امروزه در بسیاری از زمینهها از جمله تشخیص تصویر، ترجمه زبان، تشخیص صدا، پیشبینی بازار و حتی بازیهای استراتژیک کاربرد دارند. اما چگونه این سیستمها میآموزند؟ دادههای آموزشی آنها از کجا میآیند؟ و چه نکاتی باید در استفاده از آنها در نظر گرفت؟ در این مقاله به بررسی این موضوعات میپردازیم و همچنین به برخی از اشتباهات رایج در استفاده از مدلهای هوش مصنوعی اشاره میکنیم.
چگونه مدلهای هوش مصنوعی آموزش میبینند؟
مدلهای هوش مصنوعی با استفاده از روشهای مختلفی آموزش میبینند. یکی از رایجترین روشها آموزش با نظارت (Supervised Learning) است. در این روش، مدل با دادههای برچسبدار (لبلدار) آموزش میبیند. به عنوان مثال، اگر یک مدل برای تشخیص گربه و سگ آموزش میبیند، به آن مجموعهای از تصاویر گربه و سگ با برچسبهای مربوطه داده میشود. مدل سپس الگوریتمهای خود را به گونهای تنظیم میکند که بتواند تصاویر جدید را به درستی طبقهبندی کند.
روش دیگری که در هوش مصنوعی استفاده میشود، آموزش بدون نظارت (Unsupervised Learning) است. در این روش، مدل با دادههایی بدون برچسب آموزش میبیند و سعی میکند الگوها و روابط بین دادهها را کشف کند. این روش در کاربردهایی مانند خوشهبندی (Clustering) و کاهش ابعاد (Dimensionality Reduction) استفاده میشود.
همچنین، روشهای دیگری مانند آموزش تقویتی (Reinforcement Learning) وجود دارند که در آن مدل با دریافت بازخورد از محیط، سعی میکند بهترین عملکرد را داشته باشد. این روش در کاربردهایی مانند بازیهای ویدئویی و رباتیک استفاده میشود.
دادههای آموزشی هوش مصنوعی از کجا میآیند؟
دادههای آموزشی یکی از مهمترین بخشهای توسعه مدلهای هوش مصنوعی هستند. این دادهها میتوانند از منابع مختلفی جمعآوری شوند:
- دادههای عمومی: بسیاری از مدلهای هوش مصنوعی از دادههای عمومی مانند متنهای اینترنت، تصاویر ویدئوهای یوتیوب، و دادههای باز استفاده میکنند. این دادهها اغلب از طریق وبکرولرها (Web Crawlers) جمعآوری میشوند.
- دادههای خصوصی: برخی شرکتها دادههای خصوصی خود را برای آموزش مدلهای هوش مصنوعی استفاده میکنند. این دادهها میتوانند شامل اطلاعات مشتریان، دادههای حسگرها، یا اطلاعات داخلی شرکت باشند.
- دادههای مصنوعی: در برخی موارد، دادههای مصنوعی (Synthetic Data) برای آموزش مدلها استفاده میشوند. این دادهها توسط الگوریتمها تولید میشوند و میتوانند در مواردی که دادههای واقعی کافی نیستند، مفید باشند.
- دادههای جمعآوریشده توسط کاربران: برخی از مدلها از دادههای جمعآوریشده توسط کاربران مانند نظرات، پستهای شبکههای اجتماعی، یا دادههای جغرافیایی استفاده میکنند.
با این حال، استفاده از دادههای شخصی یا حساس باید با رعایت قوانین مربوط به حریم خصوصی انجام شود. بسیاری از کشورها قوانین خاصی برای استفاده از دادههای شخصی دارند و شرکتها باید این قوانین را رعایت کنند.
نکات کاربردی در استفاده از مدلهای هوش مصنوعی
استفاده از مدلهای هوش مصنوعی میتواند بسیار مفید باشد، اما باید نکات مهمی را در نظر گرفت:
- کیفیت دادهها: کیفیت دادههای آموزشی تأثیر مستقیمی بر عملکرد مدل دارد. دادههای نویزدار یا نامناسب میتواند منجر به نتایج نادرست شود.
- تنوع دادهها: دادههای آموزشی باید متنوع باشند تا مدل بتواند در شرایط مختلف عملکرد خوبی داشته باشد.
- بررسی مداوم: مدلهای هوش مصنوعی باید بهطور مداوم بررسی شوند تا از عملکرد صحیح آنها اطمینان حاصل شود.
- آموزش مداوم: مدلها باید بهطور مداوم با دادههای جدید آموزش ببینند تا بتوانند با تغییرات محیط سازگار شوند.
همچنین، باید توجه داشت که مدلهای هوش مصنوعی ممکن است در برخی موارد دچار اشتباه شوند. این اشتباهات میتواند به دلایل مختلفی مانند دادههای ناکافی، نویز در دادهها، یا محدودیتهای الگوریتمی باشد.
اشتباهات رایج در استفاده از مدلهای هوش مصنوعی
در استفاده از مدلهای هوش مصنوعی، اشتباهات رایجی وجود دارد که میتواند منجر به نتایج نامطلوب شود:
- استفاده از دادههای ناکافی: اگر دادههای آموزشی کافی نباشد، مدل نمیتواند به درستی آموزش ببیند و عملکرد ضعیفی خواهد داشت.
- بیتوجهی به حریم خصوصی: استفاده از دادههای شخصی بدون اجازه یا رعایت قوانین حریم خصوصی میتواند منجر به مشکلات قانونی و اخلاقی شود.
- انتظار عملکرد کامل: مدلهای هوش مصنوعی نمیتوانند در همه شرایط عملکرد کامل داشته باشند. انتظار داشتن نتایج دقیق در همه موارد میتواند منجر به ناامیدی شود.
- نادیده گرفتن محدودیتهای الگوریتمی: هر الگوریتم هوش مصنوعی محدودیتهایی دارد. نادیده گرفتن این محدودیتها میتواند منجر به نتایج نادرست شود.
برای استفاده مؤثر از مدلهای هوش مصنوعی، باید این اشتباهات را در نظر گرفت و سعی کرد با استفاده از دادههای مناسب و روشهای صحیح، بهترین نتایج را کسب کرد.
چالشهای پیش روی هوش مصنوعی
با وجود پیشرفتهای زیادی که در زمینه هوش مصنوعی صورت گرفته است، هنوز چالشهای بسیاری وجود دارد. یکی از مهمترین چالشها، نیاز به دادههای بزرگ و متنوع است. جمعآوری و پردازش این دادهها میتواند بسیار زمانبر و هزینهبر باشد.
چالش دیگری که وجود دارد، مربوط به تفسیرپذیری (Interpretability) مدلهای هوش مصنوعی است. بسیاری از مدلها مانند شبکههای عصبی عمیق، مانند یک “جعبه سیاه” عمل میکنند و دشوار است که بفهمیم چگونه به نتیجه رسیدهاند. این موضوع میتواند در کاربردهایی مانند پزشکی یا مالی که نیاز به توضیح دقیق نتایج است، مشکلساز باشد.
همچنین، مسائل اخلاقی و اجتماعی نیز در استفاده از هوش مصنوعی بسیار مهم هستند. استفاده نادرست از این فناوری میتواند منجر به تبعیض، نقض حریم خصوصی، یا حتی تهدید به امنیت ملی شود. بنابراین، باید در استفاده از این فناوری دقت زیادی داشت و از اصول اخلاقی پیروی کرد.
نکات پایانی
هوش مصنوعی یکی از مهمترین فناوریهای امروزی است که در بسیاری از زمینهها کاربرد دارد. برای استفاده مؤثر از این فناوری، باید به نکات مختلفی مانند کیفیت دادهها، تنوع دادهها، و بررسی مداوم مدلها توجه کرد. همچنین، باید از اشتباهات رایج مانند استفاده از دادههای ناکافی یا نادیده گرفتن حریم خصوصی پرهیز کرد.
در نهایت، باید توجه داشت که هوش مصنوعی ابزاری است که میتواند به انسان کمک کند، اما نمیتواند جایگزین تصمیمگیری انسان شود. استفاده صحیح و مسئولانه از این فناوری میتواند منجر به پیشرفتهای بسیاری در جامعه شود. برای اطلاعات بیشتر در مورد کاربردهای هوش مصنوعی در زمینههای مختلف، میتوانید به دیلی ۲۴ مراجعه کنید.