سوگیری هوش مصنوعی چیست و چرا الگوریتمها همیشه بیطرف نیستند؛ نکات مهم و کاربردی
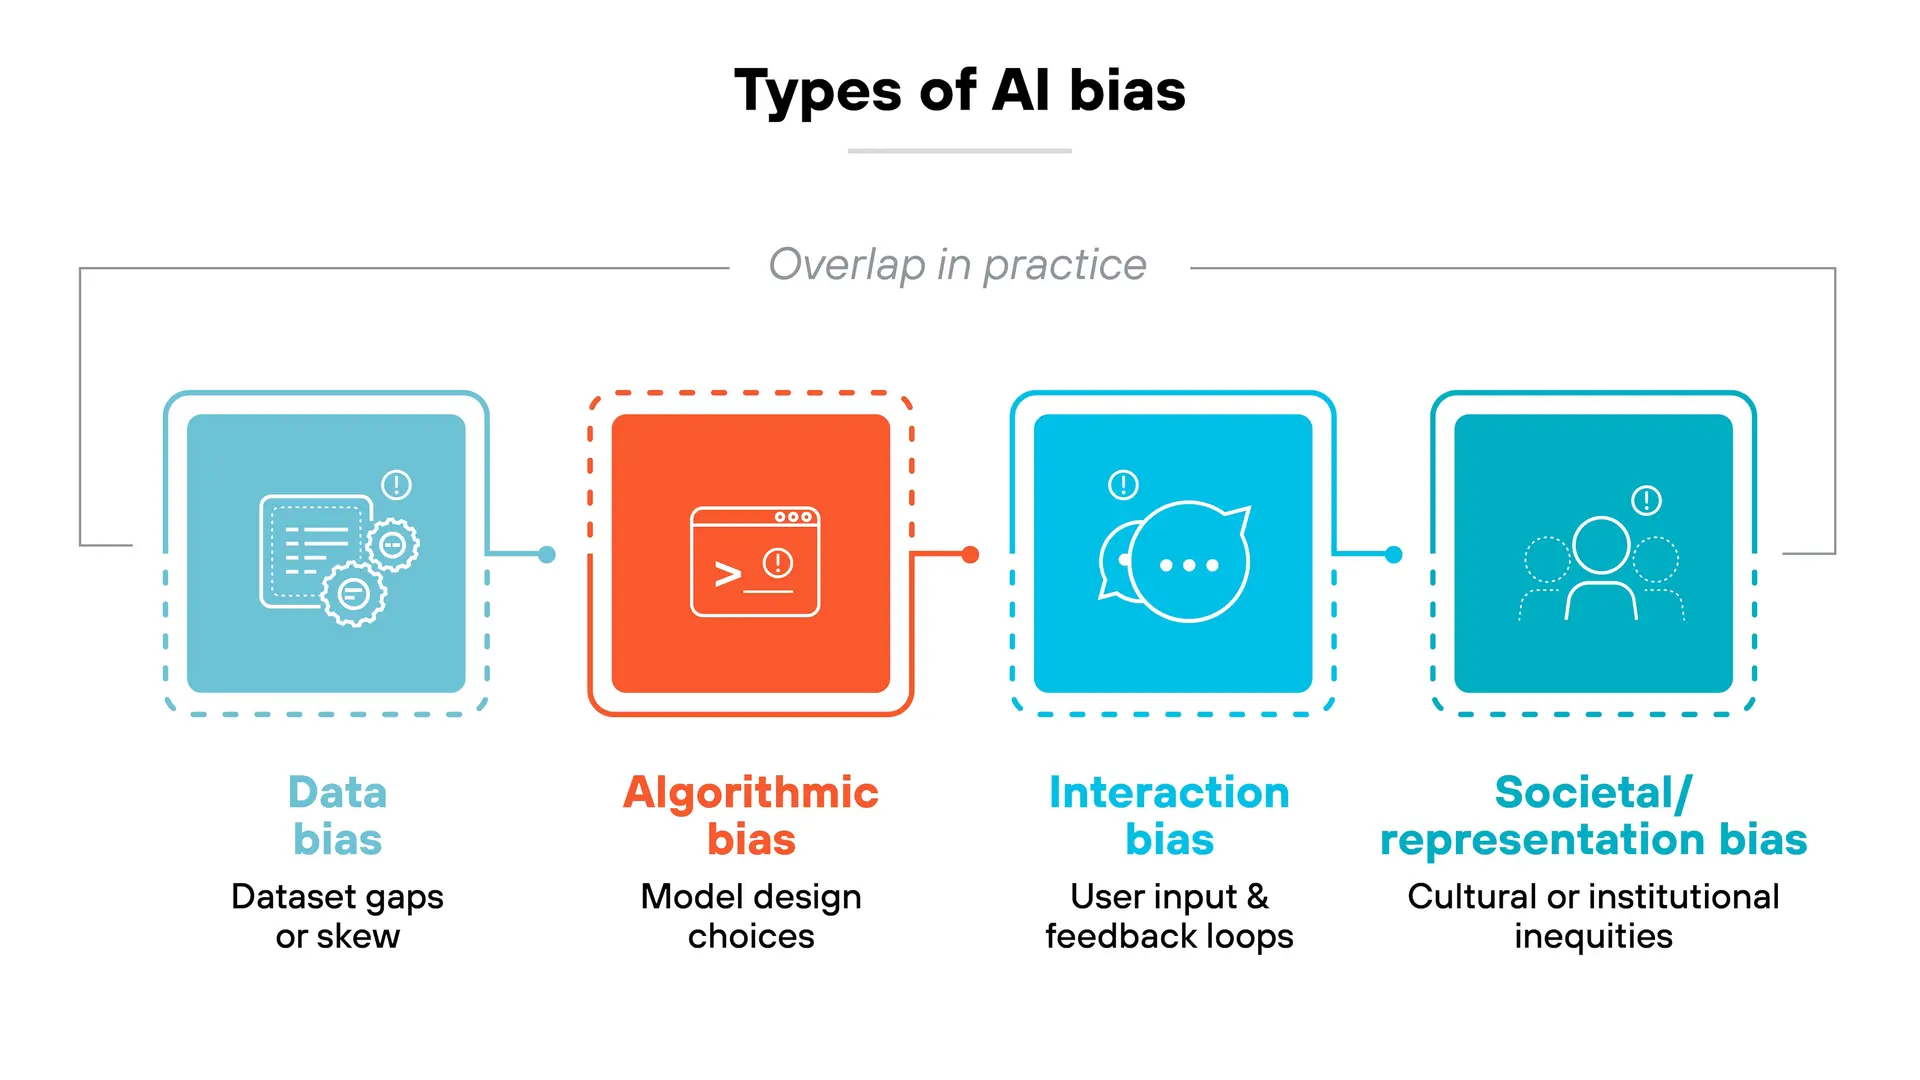
هوش مصنوعی امروزه به یکی از مهمترین ابزاری تبدیل شده که در زندگی روزمره، کسبوکار، سیاست و حتی تصمیمگیریهای شخصی ما نقش دارد. اما یکی از چالشهای اساسی در استفاده از این فناوری، وجود سوگیری در الگوریتمهای هوش مصنوعی است. سوگیری هوش مصنوعی به معنای این است که سیستمهای هوش مصنوعی به دلیل نقص در دادهها، طراحی نادرست یا حتی پیشداوریهای انسانی، نتایج ناعادلانه یا نادرست تولید میکنند. این موضوع میتواند تأثیرات جدی بر زندگی افراد داشته باشد و به همین دلیل شناخت آن ضروری است.
سوگیری هوش مصنوعی چیست؟
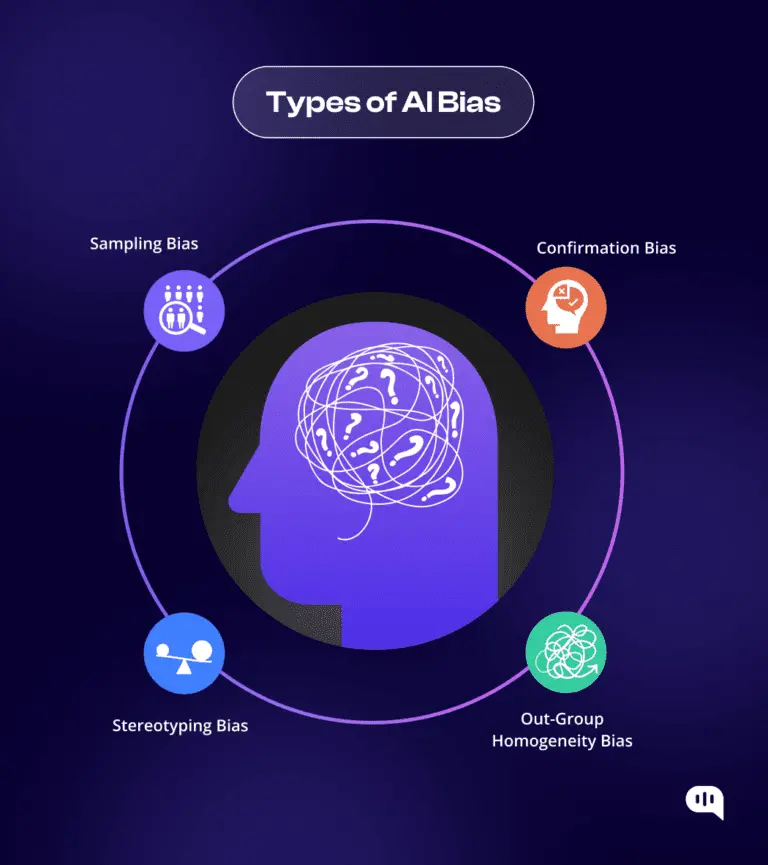
سوگیری در هوش مصنوعی زمانی رخ میدهد که یک مدل یادگیری ماشین به دلیل دادههای ناکافی، نابرابر یا دارای خطا، نتایج ناعادلانه تولید کند. این سوگیریها میتوانند در هر مرحله از طراحی و اجرای الگوریتمها رخ دهند، از جمعآوری دادهها تا تفسیر نتایج. برای مثال، اگر یک الگوریتم تشخیص چهره برای تشخیص نژاد افراد آموزش دیده باشد و دادههای آموزشی آن بیشتر شامل افراد سفیدپوست باشد، احتمال دارد در تشخیص افراد با پوست تیره دقت کمتری داشته باشد.
سوگیریها میتوانند به صورت مستقیم یا غیرمستقیم در الگوریتمها ظاهر شوند. سوگیری مستقیم زمانی رخ میدهد که مدل بهطور آشکار نتایج ناعادلانهای تولید کند، مانند تمایل به رد درخواست وام برای افراد با نامهای خاص. سوگیری غیرمستقیم اما زمانی است که الگوریتم بهطور غیرمستقیم به نتایج ناعادلانه میانجامد، مانند استفاده از دادههایی که بهطور غیرمستقیم نابرابر هستند.
چرا الگوریتمها بیطرف نیستند؟
الگوریتمهای هوش مصنوعی بهطور ذاتی بیطرف نیستند، زیرا توسط انسانها طراحی و آموزش داده میشوند. دادههای آموزشی که برای آموزش این مدلها استفاده میشود، خود میتوانند سوگیریهای اجتماعی، فرهنگی یا تاریخی را منعکس کنند. برای مثال، اگر دادههای تاریخی نشاندهنده تبعیض جنسیتی در بازار کار باشند، الگوریتمی که برای پیشبینی موفقیت شغلی آموزش میبیند، ممکن است این سوگیری را نیز تقلید کند.
علاوه بر این، انتخاب ویژگیهای داده نیز میتواند نقش مهمی در ایجاد سوگیری داشته باشد. برای مثال، استفاده از کد پستی به عنوان یک ویژگی در مدلهای پیشبینی درآمد ممکن است بهطور غیرمستقیم نابرابریهای اجتماعی را تقویت کند، زیرا کد پستیها میتوانند با مناطق خاصی مرتبط باشند که خود دارای سوگیریهای اجتماعی هستند.
همچنین، هدفگذاری و طراحی الگوریتمها نیز میتواند سوگیری ایجاد کند. اگر هدف اصلی یک الگوریتم افزایش دقت کلی باشد، ممکن است مدل به سوگیریهای خاصی تمایل داشته باشد تا دقت کلی را بهبود بخشد، حتی اگر این سوگیریها ناعادلانه باشند.
نکات مهم در شناسایی و کاهش سوگیری در هوش مصنوعی
شناسایی و کاهش سوگیری در الگوریتمهای هوش مصنوعی نیازمند توجه به چند نکته اساسی است:
- تحلیل دادهها: بررسی دادههای آموزشی برای شناسایی سوگیریهای بالقوه ضروری است. این شامل بررسی توزیع دادهها، وجود دادههای ناکافی یا نابرابر و همچنین بررسی ویژگیهای داده برای شناسایی سوگیریهای پنهان است.
- تنوع در دادهها: استفاده از دادههای متنوع و representative از جمعیت هدف میتواند کمک کند تا سوگیریها کاهش یابند. این شامل جمعآوری دادهها از گروههای مختلف اجتماعی، فرهنگی و جغرافیایی است.
- ارزیابی مداوم: الگوریتمها باید بهطور مداوم ارزیابی شوند تا سوگیریهای جدید شناسایی و اصلاح شوند. این ارزیابی باید شامل بررسی نتایج الگوریتم در گروههای مختلف باشد.
- شفافیت: شفافیت در طراحی و عملکرد الگوریتمها میتواند کمک کند تا سوگیریها شناسایی و اصلاح شوند. این شامل توضیح روشهای استفاده شده در آموزش الگوریتم و همچنین نتایج تولید شده است.
- ارزیابی اخلاقی: ارزیابی اخلاقی الگوریتمها نیز ضروری است. این شامل بررسی اینکه آیا الگوریتمها بهطور عادلانه عمل میکنند و آیا نتایج آنها میتواند تأثیر منفی بر گروههای خاصی داشته باشد.
چالشهای کاهش سوگیری در هوش مصنوعی
در حالی که شناسایی و کاهش سوگیری در هوش مصنوعی اهمیت دارد، اما چالشهای متعددی در این زمینه وجود دارد. یکی از اصلیترین چالشها، تعریف دقیق عدالت در الگوریتمها است. عدالت چیست؟ آیا عدالت به معنای برابر بودن نتایج برای همه است یا به معنای برابر بودن فرصتها؟ این سؤالات هنوز پاسخ دقیقی ندارند و میتوانند تأثیر زیادی بر طراحی الگوریتمها داشته باشند.
چالش دیگر، وجود دادههای ناکافی یا نابرابر است. در بسیاری از موارد، دادههای کافی برای آموزش الگوریتمها بدون سوگیری وجود ندارد. برای مثال، در زمینههای پزشکی، دادههای مربوط به گروههای اقلیت ممکن است بسیار محدود باشد، که این خود میتواند سوگیری ایجاد کند.
علاوه بر این، کاهش سوگیری نیازمند همکاری بین متخصصان مختلف است، از جمله متخصصان داده، اخلاقدانان، جامعهشناسان و حتی سیاستگذاران. این همکاری میتواند پیچیده باشد و نیاز به زمان و منابع زیادی دارد.
مثالهای واقعی سوگیری در هوش مصنوعی
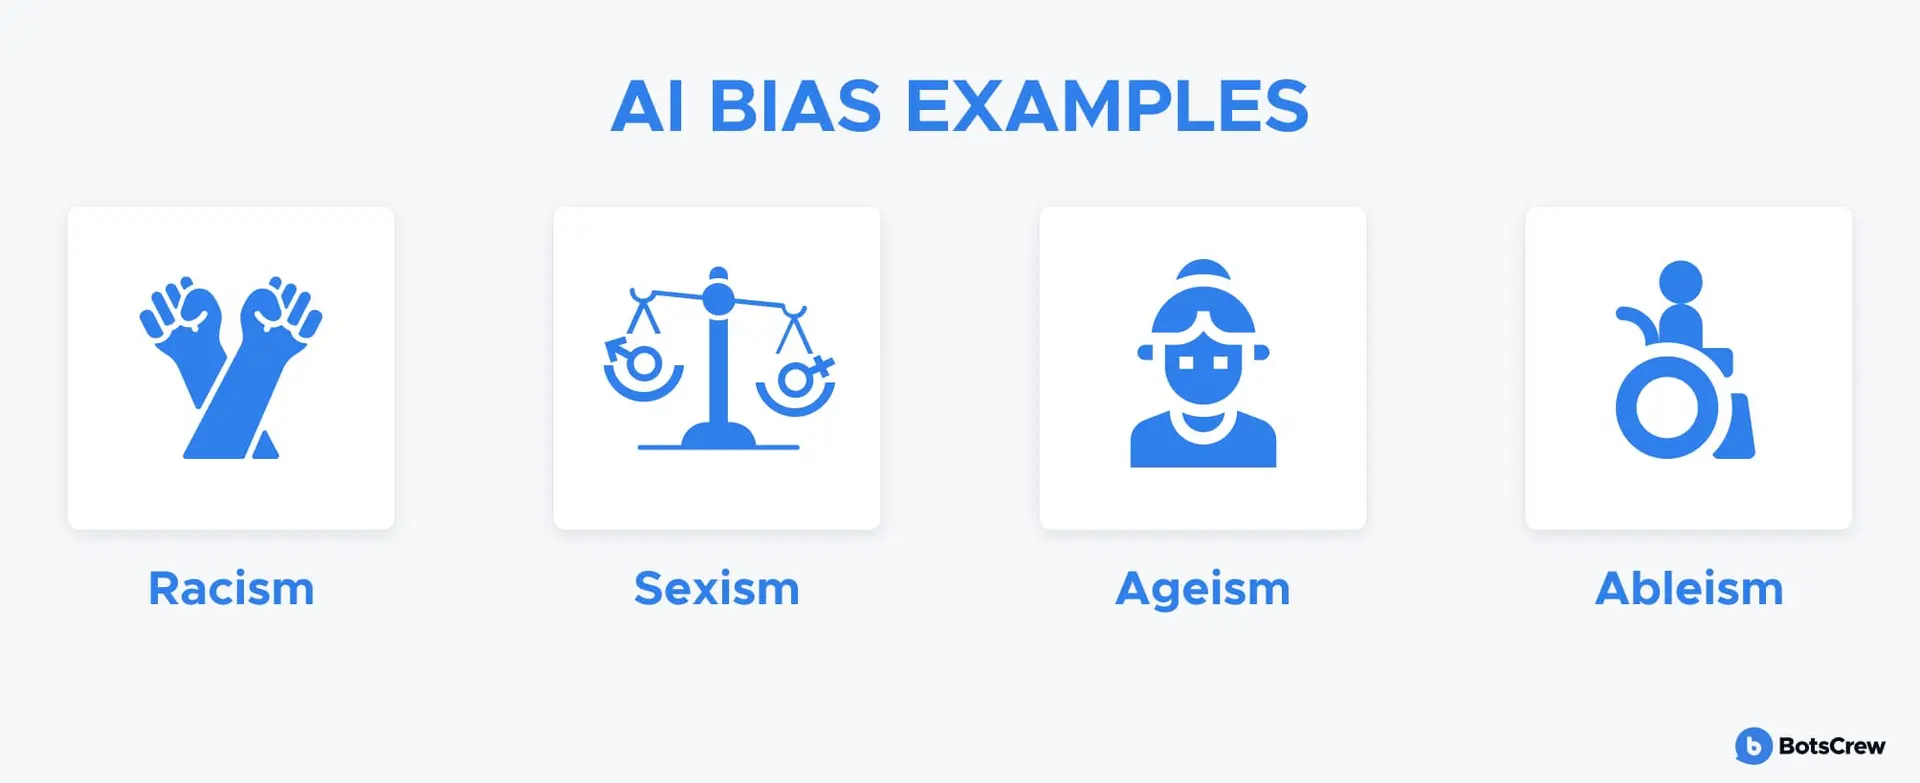
سوگیری در هوش مصنوعی در دنیای واقعی نیز دیده شده است. برای مثال، یکی از موارد معروف، استفاده از الگوریتمهای هوش مصنوعی در سیستمهای قضایی است. در سالهای گذشته، گزارشهایی منتشر شده که نشان میدهد برخی از الگوریتمهای پیشبینی خطر مجرمیت، سوگیریهای نژادی دارند و احتمال بیشتری برای پیشبینی خطر مجرمیت در افراد سیاهپوست دارند.
مثال دیگر، استفاده از الگوریتمهای هوش مصنوعی در مصاحبههای شغلی است. برخی از شرکتها از الگوریتمها برای ارزیابی رزومههای کارمندان استفاده میکنند، اما این الگوریتمها ممکن است سوگیریهای جنسیتی یا نژادی داشته باشند و باعث رد شدن افراد با استعداد از گروههای خاص شوند.
در زمینه بهداشت و درمان نیز، سوگیری در الگوریتمهای تشخیص بیماری میتواند تأثیرات جدی داشته باشد. برای مثال، اگر الگوریتم تشخیص بیماری قلبی با دادههای بیشتر از مردان آموزش دیده باشد، ممکن است در تشخیص بیماری در زنان دقت کمتری داشته باشد.
چگونه میتوانیم با سوگیری در هوش مصنوعی مقابله کنیم؟
برای مقابله با سوگیری در هوش مصنوعی، چند راهکار اساسی وجود دارد که میتوان از آنها استفاده کرد:
- آگاهی: اولین گام، آگاهی از وجود سوگیری و تأثیرات آن است. افراد و سازمانها باید به اهمیت عدالت در الگوریتمها پی ببرند و تلاش کنند تا سوگیریها را شناسایی و کاهش دهند.
- دادههای متنوع: استفاده از دادههای متنوع و representative از جمعیت هدف میتواند کمک کند تا سوگیریها کاهش یابند. این شامل همکاری با گروههای مختلف اجتماعی و فرهنگی برای جمعآوری دادهها است.
- ارزیابی مداوم: الگوریتمها باید بهطور مداوم ارزیابی شوند تا سوگیریهای جدید شناسایی و اصلاح شوند. این ارزیابی باید شامل بررسی نتایج الگوریتم در گروههای مختلف باشد.
- شفافیت و مسئولیتپذیری: شفافیت در طراحی و عملکرد الگوریتمها میتواند کمک کند تا سوگیریها شناسایی و اصلاح شوند. همچنین، مسئولیتپذیری در استفاده از الگوریتمها ضروری است تا در صورت بروز سوگیری، مسئولان شناسایی و پاسخگو باشند.
- تعاون چند رشتهای: همکاری بین متخصصان مختلف، از جمله متخصصان داده، اخلاقدانان، جامعهشناسان و سیاستگذاران، میتواند کمک کند تا سوگیریها شناسایی و کاهش یابند.
سوگیری در هوش مصنوعی یک چالش پیچیده است که نیاز به توجه مداوم و همکاری بین رشتهای دارد. با این حال، با آگاهی و اقدامات مناسب، میتوان این سوگیریها را کاهش داد و از تأثیرات منفی آنها جلوگیری کرد. برای اطلاعات بیشتر در مورد چگونگی استفاده صحیح از هوش مصنوعی و کاهش سوگیریها، میتوانید به مقالات مرتبط در دیلی 24 مراجعه کنید.