داده برچسبگذاریشده چیست و چرا برای آموزش هوش مصنوعی اهمیت دارد؛ راهنمای کامل و کاربردی
در دنیای امروزی که هوش مصنوعی به یکی از مهمترین ابزارهای تحول در صنایع مختلف تبدیل شده است، یکی از مفاهیم اساسی که کمتر مورد توجه قرار میگیرد اما نقش حیاتی در عملکرد سیستمهای هوش مصنوعی دارد، داده برچسبگذاریشده است. این مفهوم به ویژه در زمینه آموزش مدلهای یادگیری ماشین و شبکههای عصبی اهمیت بسیاری دارد. اما داده برچسبگذاریشده دقیقاً چیست؟ چرا برای آموزش هوش مصنوعی اینقدر حیاتی است؟ و چگونه میتوانیم از آن به بهترین نحو استفاده کنیم؟ در این راهنمای کامل، به این سوالات پاسخ خواهیم داد و همچنین به بررسی کاربردهای عملی و چالشهای مرتبط با این موضوع میپردازیم.
داده برچسبگذاریشده چیست؟
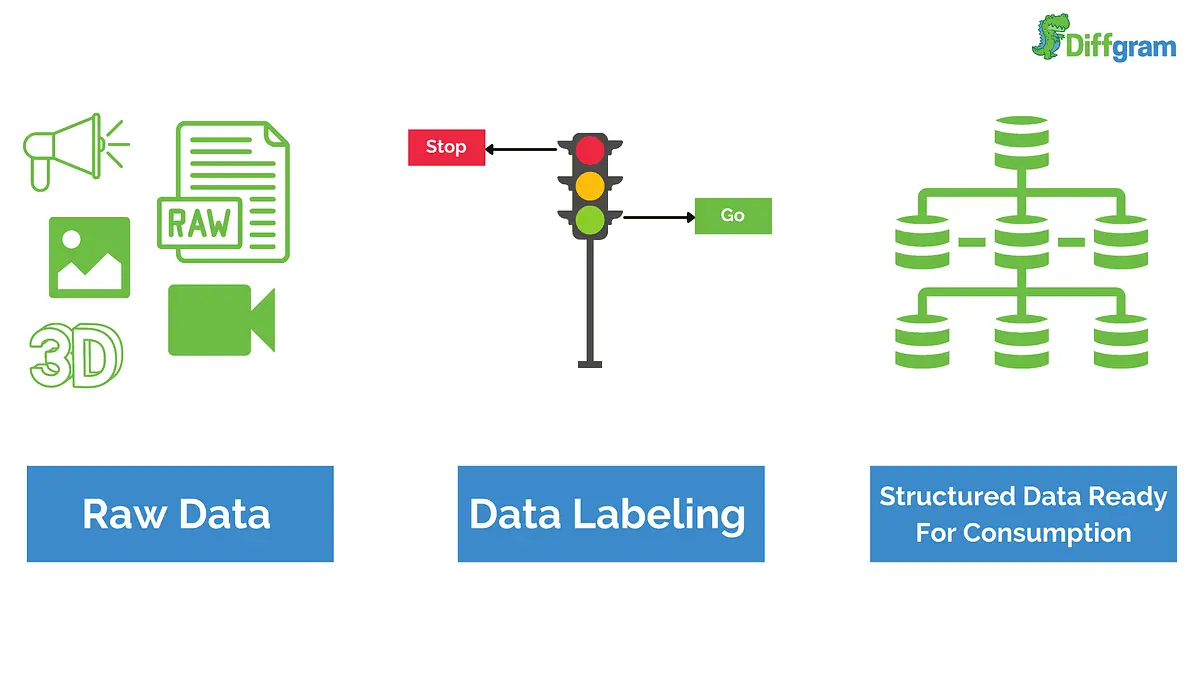
داده برچسبگذاریشده یا لبلزدن داده فرایندی است که در آن دادههای خام به صورت دستی یا با استفاده از الگوریتمها، با برچسبهای مشخصی همراه میشوند. این برچسبها میتوانند شامل دستهبندیها، شناسایی اشیا، تشخیص احساسات، یا حتی اطلاعات جغرافیایی باشند. برای مثال، در یک مجموعه داده تصاویر، هر تصویر ممکن است با برچسبی مانند “گربه”، “سگ”، یا “پارو” همراه شود تا مدل یادگیری ماشین بتواند این اشیا را تشخیص دهد.
این فرآیند به مدلهای هوش مصنوعی کمک میکند تا از دادههای برچسبگذاریشده برای یادگیری الگوهای مختلف استفاده کنند. بدون این برچسبها، سیستمها نمیتوانند تفاوت بین دادههای مختلف را تشخیص دهند و به نتیجهای دقیق و قابل اعتماد برسند.
چرا داده برچسبگذاریشده برای آموزش هوش مصنوعی اهمیت دارد؟
اهمیت داده برچسبگذاریشده در آموزش هوش مصنوعی از چند جهت قابل بررسی است:
- دقت و عملکرد: مدلهای یادگیری ماشین برای عملکرد دقیق به دادههای برچسبگذاریشده نیاز دارند. بدون برچسبها، سیستم نمیتواند تفاوت بین دادههای مختلف را تشخیص دهد و نتیجهگیریهای نادرست ارائه دهد.
- یادگیری سوپرایز: در روشهای سوپرایز (Supervised Learning)، مدلها با استفاده از دادههای برچسبگذاریشده آموزش میبینند. این روش یکی از رایجترین و مؤثرترین روشهای آموزش هوش مصنوعی است.
- کاربردهای عملی: بسیاری از کاربردهای هوش مصنوعی مانند تشخیص چهره، ترجمه ماشینی، تشخیص سرطان در تصاویر پزشکی، و حتی خودران کردن خودروها، به دادههای برچسبگذاریشده نیاز دارند.
- ارزیابی مدل: برای ارزیابی عملکرد یک مدل هوش مصنوعی، نیاز به دادههای تستی برچسبگذاریشده است تا بتوان دقت، حساسیت، و سایر متریکس عملکرد را اندازهگیری کرد.
به عبارت دیگر، داده برچسبگذاریشده مانند یک راهنمای آموزشی برای هوش مصنوعی عمل میکند. بدون این راهنما، سیستم نمیتواند تفاوت بین دادههای مختلف را درک کند و به نتیجهای قابل اعتماد برسد.
چالشهای مرتبط با داده برچسبگذاریشده
در حالی که داده برچسبگذاریشده نقش حیاتی در آموزش هوش مصنوعی دارد، این فرآیند نیز با چالشهایی همراه است:
- زمانیبر: برچسبگذاری دادهها به ویژه در حجمهای بزرگ، فرایندی زمانبر است و نیاز به نیروی انسانی یا منابع محاسباتی زیادی دارد.
- دقت: اگر دادهها به درستی برچسبگذاری نشوند، مدلهای هوش مصنوعی ممکن است نتایج نادرستی ارائه دهند. این موضوع به ویژه در کاربردهای حساس مانند تشخیص پزشکی بسیار مهم است.
- هزینه: برچسبگذاری دادهها به ویژه در حجمهای بزرگ، هزینههای زیادی را به همراه دارد. این هزینهها شامل هزینه نیروی انسانی، ابزارهای نرمافزاری، و زمان مورد نیاز است.
- تعدیل دادهها: در برخی موارد، دادههای برچسبگذاریشده ممکن است نیاز به تعدیل و تصحیح داشته باشند، که این خود فرایندی پیچیده و زمانبر است.
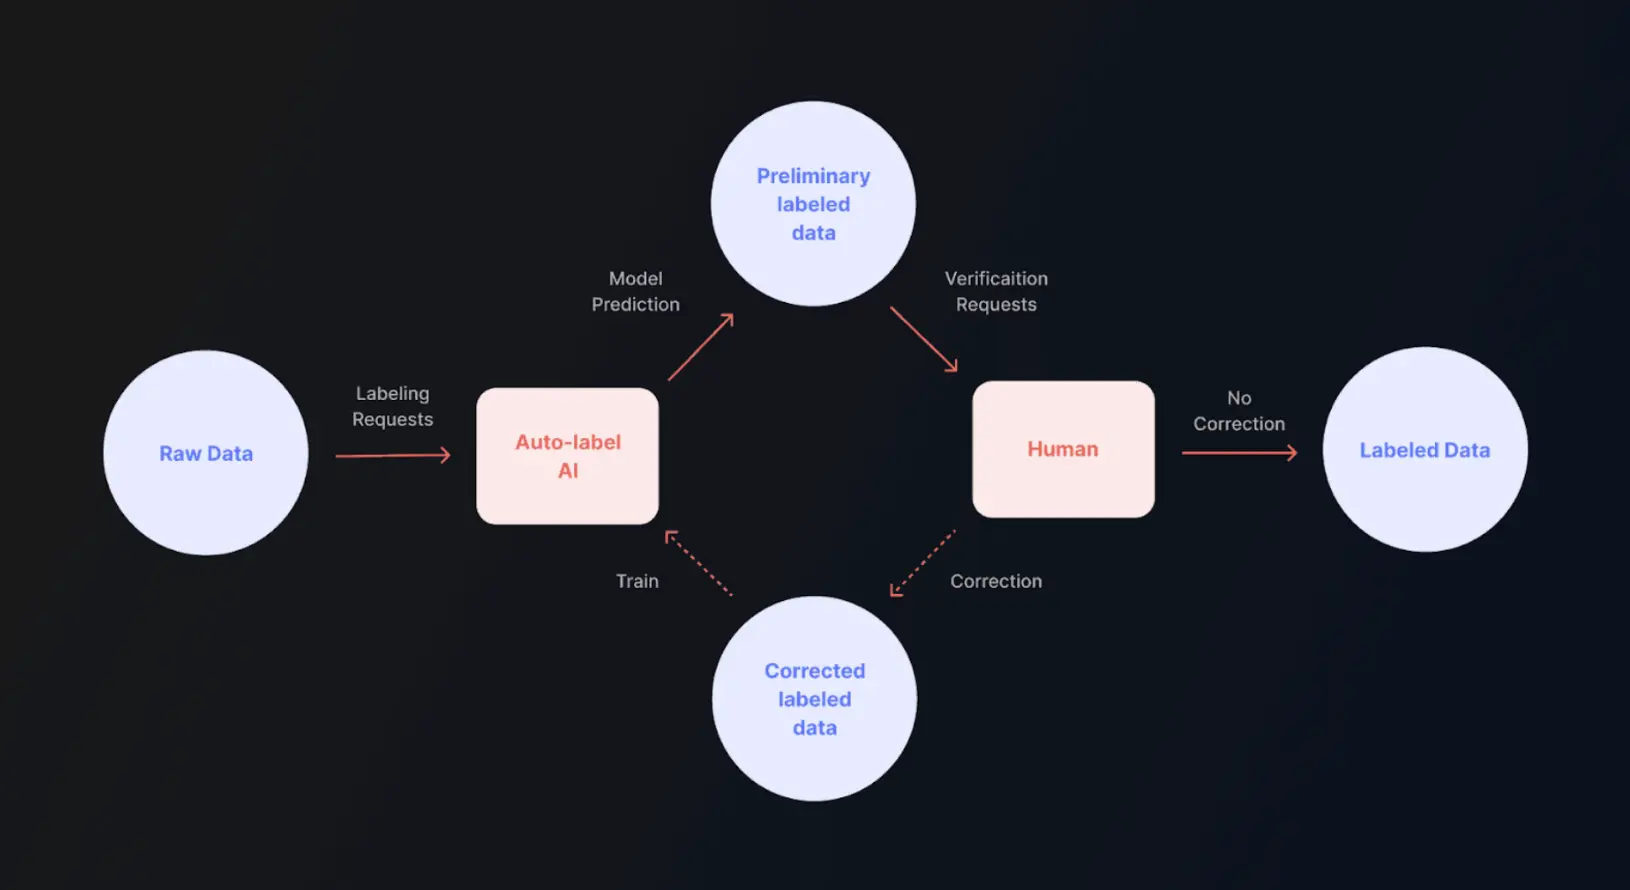
با این حال، با استفاده از ابزارهای خودکار و الگوریتمهای پیشرفته، بسیاری از این چالشها قابل کاهش هستند. برای مثال، استفاده از یادگیری عمیق و شبکههای عصبی میتواند در برخی موارد به کاهش نیاز به برچسبگذاری دستی کمک کند.
راهکارهای بهبود داده برچسبگذاریشده
برای بهبود کیفیت و کارایی دادههای برچسبگذاریشده، میتوان از راهکارهای زیر استفاده کرد:
- استفاده از ابزارهای خودکار: ابزارهای مختلفی مانند Labelbox، Amazon SageMaker Ground Truth، و CVAT وجود دارند که میتوانند در برچسبگذاری دادهها کمک کنند. این ابزارها میتوانند فرآیند را سریعتر و دقیقتر کنند.
- تولید دادههای مصنوعی: در برخی موارد، استفاده از دادههای مصنوعی یا افزایش دادهها (Data Augmentation) میتواند به کاهش نیاز به برچسبگذاری دستی کمک کند.
- ارزیابی کیفیت: بررسی و ارزیابی کیفیت دادههای برچسبگذاریشده توسط متخصصان میتواند به بهبود دقت مدلها کمک کند.
- استفاده از یادگیری نیمهنظارت: در برخی موارد، استفاده از روشهای نیمهنظارت (Semi-Supervised Learning) میتواند به کاهش نیاز به دادههای برچسبگذاریشده کمک کند.
همچنین، همکاری بین متخصصان حوزه داده، مهندسان هوش مصنوعی، و کارشناسان موضوعی میتواند به بهبود کیفیت دادههای برچسبگذاریشده کمک کند.
کاربردهای عملی داده برچسبگذاریشده
داده برچسبگذاریشده در بسیاری از حوزهها کاربرد دارد. برخی از این کاربردها عبارتند از:
- تشخیص تصویر: در سیستمهای تشخیص چهره، تشخیص اشیا، و تشخیص سرطان در تصاویر پزشکی، دادههای برچسبگذاریشده نقش اساسی دارند.
- پردازش زبان طبیعی: در ترجمه ماشینی، تشخیص احساسات، و پاسخگویی به سوالات، دادههای برچسبگذاریشده برای آموزش مدلها استفاده میشوند.
- خودران: در سیستمهای خودران، دادههای برچسبگذاریشده برای تشخیص اشیا، تشخیص ترافیک، و تصمیمگیری در زمان واقعی استفاده میشوند.
- تجارت الکترونیک: در سیستمهای توصیهگر، دادههای برچسبگذاریشده برای تحلیل رفتار کاربران و ارائه پیشنهادات شخصیسازی شده استفاده میشوند.
در هر یک از این حوزهها، کیفیت و دقت دادههای برچسبگذاریشده بهطور مستقیم بر عملکرد سیستمهای هوش مصنوعی تأثیر میگذارد.
نکات پایانی و راهنمایی برای شروع
اگر قصد دارید در پروژههای هوش مصنوعی فعالیت کنید یا میخواهید دادههای خود را برای آموزش مدلها آماده کنید، توجه به نکات زیر میتواند کمککننده باشد:
- از ابزارهای مناسب برای برچسبگذاری دادهها استفاده کنید تا فرآیند را سریعتر و دقیقتر کنید.
- به کیفیت دادهها توجه کنید و از ارزیابی مداوم دادههای برچسبگذاریشده استفاده کنید.
- در صورت امکان، از دادههای مصنوعی یا افزایش دادهها استفاده کنید تا نیاز به برچسبگذاری دستی را کاهش دهید.
- با متخصصان حوزه داده و هوش مصنوعی همکاری کنید تا بهترین نتایج را کسب کنید.
در نهایت، داده برچسبگذاریشده یکی از ستونهای اصلی آموزش هوش مصنوعی است. بدون این دادهها، سیستمها نمیتوانند به دقت و کارایی مورد نیاز برسند. با توجه به اهمیت این موضوع، سرمایهگذاری در کیفیت و دقت دادههای برچسبگذاریشده میتواند به بهبود عملکرد مدلهای هوش مصنوعی کمک شایانی کند.
برای اطلاعات بیشتر در مورد کاربردهای هوش مصنوعی و راهکارهای مرتبط، میتوانید به مقالات مرتبط در دیلی 24 مراجعه کنید.