تشخیص تقلب مالی با یادگیری ماشین چگونه انجام میشود؛ راهنمای کامل و کاربردی
تقلب مالی یکی از بزرگترین چالشهای سازمانها، بانکها و شرکتهای بزرگ در دنیای امروز است. هر ساله میلیاردها دلار به دلیل فعالیتهای غیرقانونی و تقلب از دست میرود و این موضوع نه تنها به زیان مالی شرکتها میانجامد، بلکه میتواند به آسیب به شهرت و اعتماد عمومی نیز منجر شود. در این میان، استفاده از فناوریهای پیشرفته مانند یادگیری ماشین به عنوان ابزاری قدرتمند برای تشخیص و پیشگیری از تقلب مالی مطرح شده است. اما چگونه این فناوری کار میکند؟ چه روشهایی برای تشخیص تقلب با استفاده از یادگیری ماشین وجود دارد؟ و چه مزایایی نسبت به روشهای سنتی دارد؟ در این راهنما کامل، به بررسی این موضوعات میپردازیم و شما را با مراحل عملی تشخیص تقلب مالی با یادگیری ماشین آشنا میکنیم.
یادگیری ماشین و تشخیص تقلب مالی: چرا این فناوری مهم است؟
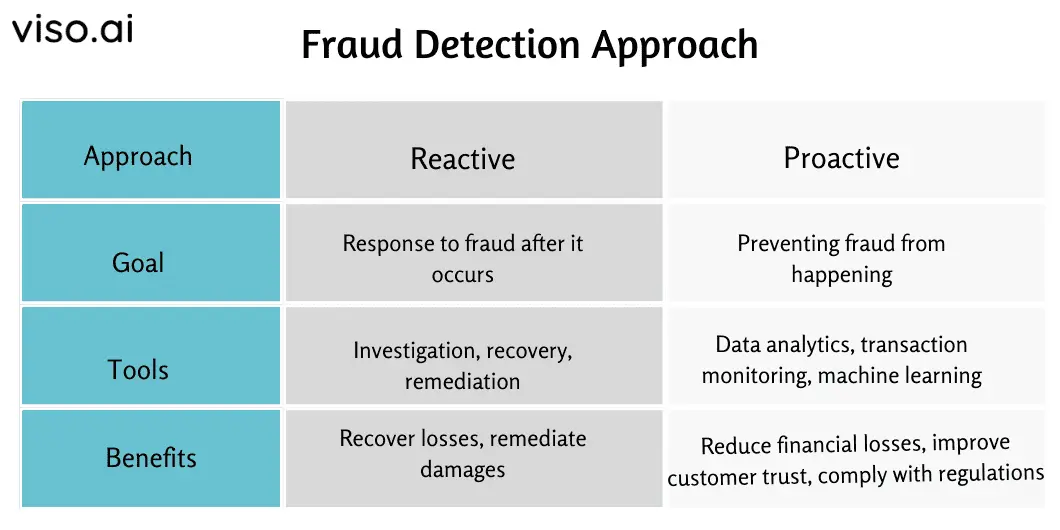
یادگیری ماشین (Machine Learning) زیرشاخهای از هوش مصنوعی است که به سیستمها اجازه میدهد از دادهها یاد بگیرند و بدون برنامهریزی صریح، به بهبود عملکرد خود بپردازند. در زمینه تشخیص تقلب، این فناوری میتواند الگوها و رفتارهای غیرعادی را شناسایی کند که ممکن است نشانهای از فعالیتهای مشکوک باشند. در حالی که روشهای سنتی تشخیص تقلب مانند بررسی دستی یا استفاده از قوانین ثابت، محدودیتهای زیادی دارند، مدلهای یادگیری ماشین میتوانند با تحلیل حجم عظیم دادهها و شناسایی الگوهای پنهان، کارایی بالایی داشته باشند.
یکی از دلایل اصلی اهمیت یادگیری ماشین در تشخیص تقلب، توانایی آن در پردازش دادههای بزرگ و پیچیده است. امروزه سازمانها با حجم زیادی از تراکنشهای مالی، اطلاعات مشتریان و فعالیتهای روزانه مواجه هستند. تحلیل دستی این دادهها نه تنها زمانبر است، بلکه امکان خطا نیز دارد. مدلهای یادگیری ماشین میتوانند این دادهها را در زمان واقعی یا نزدیک به زمان واقعی تحلیل کنند و خطرات احتمالی را شناسایی نمایند.
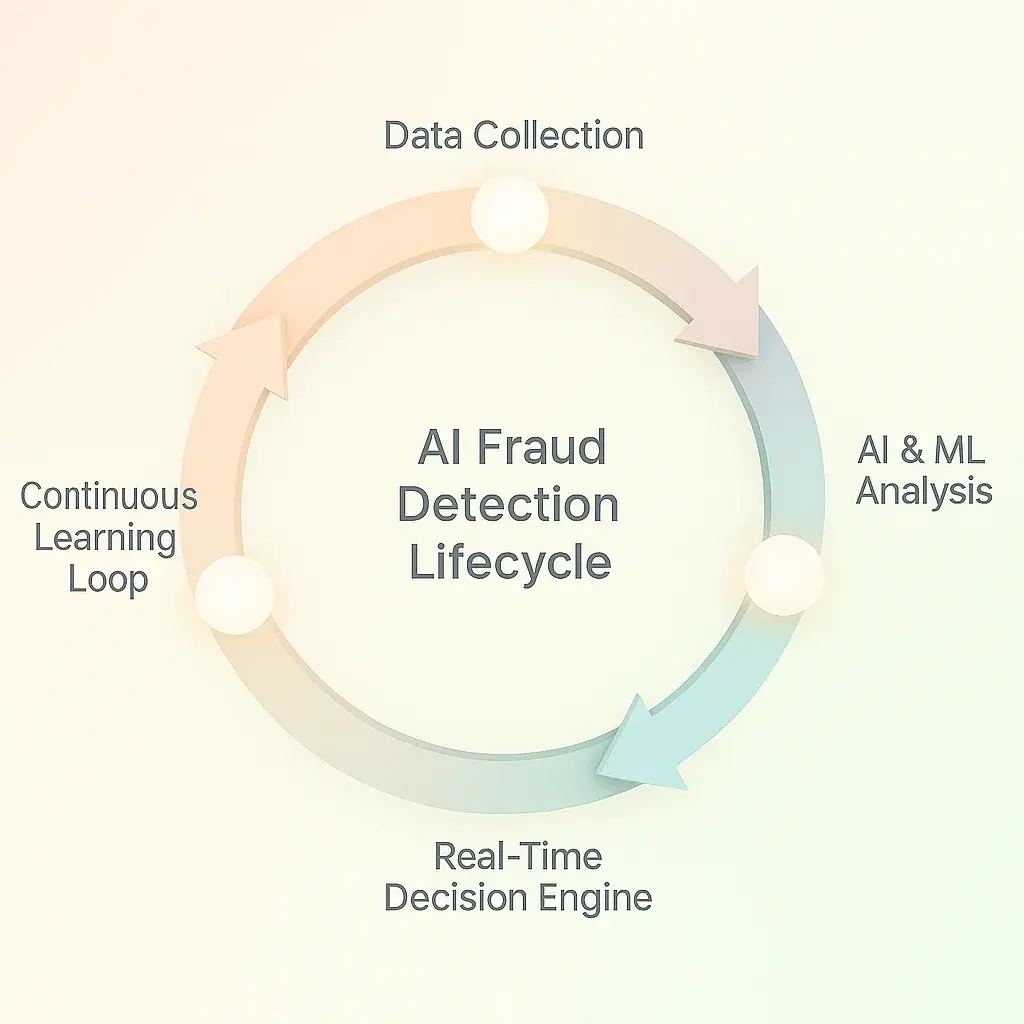
علاوه بر این، مدلهای یادگیری ماشین میتوانند با یادگیری مداوم از دادههای جدید، خود را بهروزرسانی کنند و در برابر تغییرات در روشهای تقلب، انعطافپذیر باشند. این ویژگی به ویژه در دنیای مالی که روشهای جدید تقلب به سرعت ظاهر میشوند، بسیار ارزشمند است.
چگونه یادگیری ماشین تقلب مالی را تشخیص میدهد؟
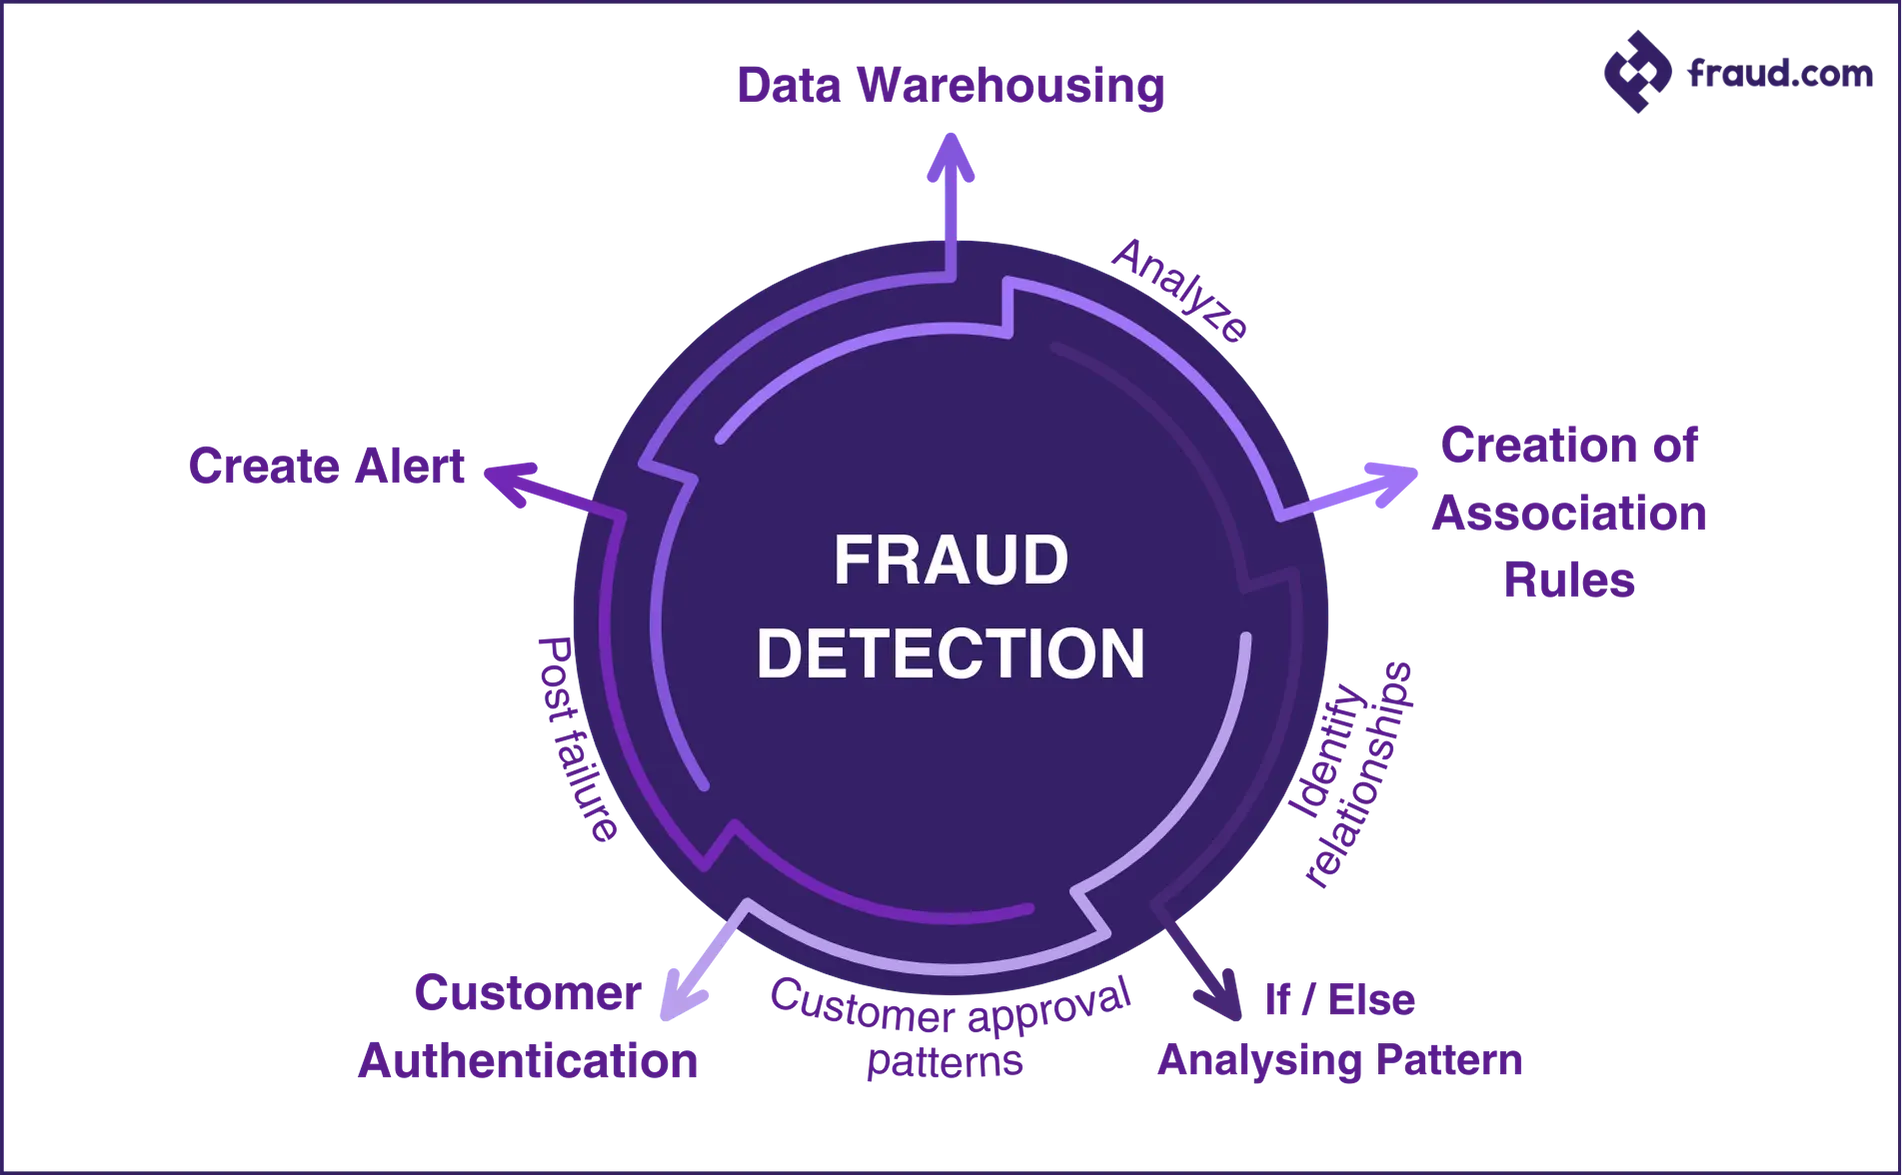
فرایند تشخیص تقلب با استفاده از یادگیری ماشین شامل چندین مرحله کلیدی است که در ادامه به آنها میپردازیم:
1. جمعآوری و آمادهسازی دادهها
اولین گام در هر پروژه یادگیری ماشین، جمعآوری دادههای مناسب است. در زمینه تشخیص تقلب، دادههای مربوط به تراکنشهای مالی، اطلاعات مشتریان، تاریخچه فعالیتهای آنها و حتی دادههای خارجی مانند گزارشهای خبری یا دادههای اقتصادی میتواند مفید باشد.
اما جمعآوری داده تنها بخشی از کار است. دادهها باید تمیز، کامل و سازگار باشند. این مرحله شامل پاکسازی دادهها (Data Cleaning)، تکمیل دادههای ناقص (Data Imputation) و تبدیل دادهها به فرمت مناسب برای مدلهای یادگیری ماشین (Feature Engineering) میشود. برای مثال، تراکنشهای مالی ممکن است شامل اطلاعات مختلفی مانند زمان، مبلغ، محل، و شناسه مشتری باشند که باید به صورت مناسب برای مدل آماده شوند.
در این مرحله، دادههای تقلب و غیرتقلب باید به درستی برچسبگذاری شوند تا مدل بتواند بین آنها تمایز قائل شود. این برچسبگذاری میتواند توسط متخصصان مالی یا با استفاده از دادههای تاریخی تأییدشده انجام شود.
2. انتخاب الگوریتم مناسب
پس از آمادهسازی دادهها، مرحله بعدی انتخاب الگوریتم یادگیری ماشین مناسب برای تشخیص تقلب است. انتخاب الگوریتم بستگی به نوع دادهها، حجم آنها، و نیازهای سازمان دارد. برخی از الگوریتمهای رایج در تشخیص تقلب مالی عبارتند از:
- الگوریتمهای مبتنی بر درخت تصمیم (Decision Trees): این الگوریتمها میتوانند روابط بین ویژگیهای دادهها را به صورت درخت نمایش دهند و به این ترتیب، الگوها را شناسایی کنند. مدلهای رندوم فارست (Random Forest) و گرادیان بوستینگ (Gradient Boosting) از این دسته هستند و در تشخیص تقلب کاربرد زیادی دارند.
- شبکههای عصبی مصنوعی (Artificial Neural Networks – ANN): این الگوریتمها میتوانند دادههای پیچیده را تحلیل کنند و به ویژه در تشخیص الگوهای پنهان در دادههای بزرگ مؤثر هستند. شبکههای عصبی عمیق (Deep Learning) مانند خودکدگذارها (Autoencoders) و شبکههای عصبی بازگشتی (Recurrent Neural Networks – RNN) نیز در تشخیص تقلب استفاده میشوند.
- الگوریتمهای کلاسترینگ (Clustering): این الگوریتمها مانند K-Means یا DBSCAN میتوانند دادهها را به گروههای مشابه تقسیم کنند و تراکنشهای غیرعادی را به عنوان گروههای کوچک یا دور از مرکز شناسایی کنند.
- الگوریتمهای مبتنی بر یادگیری عمیق (Deep Learning): مدلهای مانند LSTM (Long Short-Term Memory) برای تحلیل دادههای زمانی مانند تراکنشهای مالی در زمانهای مختلف بسیار مؤثر هستند.
انتخاب الگوریتم مناسب بستگی به نیازهای سازمان، حجم دادهها و منابع موجود دارد. برای مثال، اگر سازمانی دارای دادههای تاریخی زیادی باشد، استفاده از مدلهای یادگیری عمیق میتواند بسیار مؤثر باشد، اما برای سازمانهایی با منابع محدود، الگوریتمهای سادهتر مانند رندوم فارست ممکن است بهتر باشد.
3. آموزش مدل
پس از انتخاب الگوریتم، مدل باید با استفاده از دادههای برچسبگذاریشده آموزش داده شود. در این مرحله، مدل یاد میگیرد که چگونه تراکنشهای تقلب را از تراکنشهای عادی تشخیص دهد. آموزش مدل شامل تقسیم دادهها به مجموعههای آموزش (Training)، اعتبار سنجی (Validation) و تست (Test) است.
در این مرحله، پارامترهای مدل مانند نرخ یادگیری، تعداد لایهها در شبکه عصبی، یا عمق درخت تصمیم باید بهینهسازی شوند تا مدل بهترین عملکرد را داشته باشد. این فرآیند به عنوان تونینگ مدل (Model Tuning) شناخته میشود.
یکی از چالشهای اصلی در آموزش مدل، عدم تعادل دادهها است. در بسیاری از موارد، دادههای تقلب بسیار کمتر از دادههای عادی هستند. این موضوع میتواند باعث شود که مدل به سمت تشخیص تراکنشهای عادی به عنوان تقلب تمایل داشته باشد. برای حل این مشکل، روشهایی مانند افزایش دادههای تقلب (Oversampling) یا کاهش دادههای عادی (Undersampling) استفاده میشود.
4. ارزیابی مدل
پس از آموزش مدل، باید عملکرد آن ارزیابی شود. در تشخیص تقلب، دو نوع خطا مهم وجود دارد:
- خطای نوع اول (False Positive): تشخیص اشتباه تراکنشهای عادی به عنوان تقلب.
- خطای نوع دوم (False Negative): تشخیص اشتباه تراکنشهای تقلب به عنوان عادی.
ارزیابی مدل باید بر اساس متریکی مانند دقت (Accuracy)، حساسیت (Recall)، خاصیت (Precision)، و F1-score انجام شود. همچنین، استفاده از ماتریس混淆 (Confusion Matrix) میتواند کمک کند تا درک بهتری از عملکرد مدل داشته باشیم.
در بسیاری از موارد، کاهش خطای نوع دوم (False Negative) مهمتر است، زیرا تشخیص نکردن یک تراکنش تقلب میتواند زیانهای مالی زیادی به همراه داشته باشد. بنابراین، تنظیم پارامترهای مدل باید به گونهای باشد که حساسیت مدل بالا باشد.
5. پیادهسازی و نظارت بر مدل
پس از ارزیابی و بهینهسازی مدل، مرحله بعدی پیادهسازی آن در محیط تولید است. این مرحله شامل ادغام مدل با سیستمهای موجود سازمان، مانند سیستمهای پردازش تراکنش یا نرمافزارهای مالی، میشود.
پس از پیادهسازی، نظارت مداوم بر عملکرد مدل بسیار مهم است. دادههای جدید و تغییرات در الگوی تقلب ممکن است باعث کاهش کارایی مدل شوند. بنابراین، مدل باید بهطور دورهای با دادههای جدید آموزش داده شود و پارامترهای آن بهروزرسانی گردد.
نظارت بر مدل همچنین شامل بررسی خطاهای تشخیص شده و بررسی دستی تراکنشهایی است که توسط مدل به عنوان تقلب شناسایی شدهاند. این بررسیها میتواند به بهبود مداوم مدل کمک کند.
مزایای استفاده از یادگیری ماشین در تشخیص تقلب مالی
استفاده از یادگیری ماشین در تشخیص تقلب مالی مزایای بسیاری دارد که برخی از آنها عبارتند از:
- کارایی بالا: مدلهای یادگیری ماشین میتوانند حجم زیادی از دادهها را در زمان واقعی یا نزدیک به زمان واقعی تحلیل کنند و خطرات را به سرعت شناسایی نمایند.
- دقت بالا: با استفاده از الگوریتمهای مناسب و دادههای مناسب، مدلها میتوانند دقت بالایی در تشخیص تقلب داشته باشند.
- انعطافپذیری: مدلهای یادگیری ماشین میتوانند با یادگیری مداوم از دادههای جدید، خود را بهروزرسانی کنند و در برابر تغییرات در روشهای تقلب، انعطافپذیر باشند.
- کاهش هزینهها: تشخیص زودهنگام تقلب میتواند هزینههای مالی و قانونی سازمان را کاهش دهد.
- کاهش بار کار انسانی: با اتوماسیون فرایند تشخیص تقلب، بار کار متخصصان مالی کاهش مییابد و آنها میتوانند به کارهای استراتژیکتری بپردازند.
چالشهای تشخیص تقلب با یادگیری ماشین
در حالی که استفاده از یادگیری ماشین در تشخیص تقلب مالی مزایای بسیاری دارد، اما با چالشهایی نیز همراه است:
- عدم تعادل دادهها: به دلیل کمبود دادههای تقلب، مدلها ممکن است دچار bias شوند و عملکرد ضعیفی داشته باشند.
- تغییرات در الگوی تقلب: روشهای جدید تقلب ممکن است باعث کاهش کارایی مدل شوند و نیاز به بهروزرسانی مداوم داشته باشند.
- محدودیتهای فنی: پیادهسازی و نگهداری مدلهای یادگیری ماشین ممکن است نیاز به منابع فنی و تخصصی داشته باشد.
- مسائل اخلاقی و حقوقی: استفاده از دادههای شخصی مشتریان برای تشخیص تقلب ممکن است با قوانین حریم خصوصی در تضاد باشد.
برای مقابله با این چالشها، سازمانها باید استراتژیهای مناسب را برای جمعآوری داده، آموزش مداوم مدلها و رعایت قوانین مربوطه در نظر بگیرند.
راهنمای عملی برای شروع
اگر شما نیز قصد دارید از یادگیری ماشین برای تشخیص تقلب مالی استفاده کنید، این راهنما عملی میتواند به شما کمک کند:
1. شناسایی نیازهای سازمانی
اولین گام این است که نیازهای سازمان خود را شناسایی کنید. چه نوع تراکنشهایی نیاز به نظارت دارند؟ چه حجم دادهای باید تحلیل شوند؟ و چه سطح دقت مورد نیاز است؟ پاسخ به این سوالات میتواند به شما کمک کند تا راهکار مناسب را انتخاب کنید.
2. جمعآوری دادهها
دادههای لازم را جمعآوری کنید. این دادهها ممکن است شامل تراکنشهای مالی، اطلاعات مشتریان، و دادههای تاریخی تقلب باشند. اطمینان حاصل کنید که دادهها تمیز و سازگار هستند.
3. انتخاب الگوریتم و مدل
بر اساس نیازهای سازمان و حجم دادهها، الگوریتم مناسب را انتخاب کنید. اگر دادههای شما بزرگ و پیچیده هستند، مدلهای یادگیری عمیق ممکن است مناسبتر باشند. اما اگر منابع محدودتری دارید، الگوریتمهای سادهتر مانند رندوم فارست میتوانند انتخاب خوبی باشند.
4. آموزش و ارزیابی مدل
مدل را با استفاده از دادههای برچسبگذاریشده آموزش دهید و عملکرد آن را با استفاده از متریکهای مناسب ارزیابی کنید. توجه داشته باشید که باید بین دقت و حساسیت تعادل ایجاد کنید.
5. پیادهسازی و نظارت
مدل را در محیط تولید پیادهسازی کنید و عملکرد آن را بهطور مداوم نظارت کنید. دادههای جدید را برای بهروزرسانی مدل استفاده کنید و در صورت نیاز، پارامترهای مدل را تنظیم کنید.
در این راهنما، به بررسی روشهای تشخیص تقلب مالی با استفاده از یادگیری ماشین پرداختیم. این فناوری میتواند ابزاری قدرتمند برای سازمانها در مبارزه با تقلب باشد، اما نیاز به برنامهریزی دقیق، منابع مناسب و نظارت مداوم دارد. اگر شما نیز در زمینه مالی فعالیت میکنید و میخواهید از این فناوری استفاده کنید، میتوانید با مطالعه بیشتر و مشاوره با متخصصان، راهکار مناسبی برای سازمان خود انتخاب کنید.
برای اطلاعات بیشتر در مورد کاربردهای دیگر هوش مصنوعی در زمینههای مختلف، میتوانید به مقالات مرتبط در دیلی 24 مراجعه کنید.