یادگیری بدون نظارت چیست و چگونه الگوهای پنهان دادهها را پیدا میکند؛ راهنمای ساده برای شروع
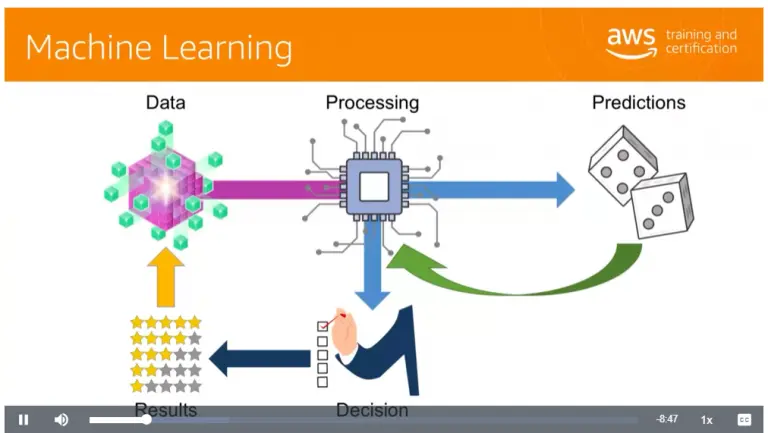
در دنیای امروزی که دادهها به یکی از مهمترین داراییهای سازمانها و شرکتها تبدیل شدهاند، تحلیل و استخراج اطلاعات ارزشمند از این حجم عظیم دادهها، چالش بزرگی بهشمار میرود. یکی از روشهای قدرتمند برای کشف الگوهای پنهان در دادهها، یادگیری بدون نظارت (Unsupervised Learning) است. این روش که یکی از سه دسته اصلی یادگیری ماشین بهشمار میرود، بدون نیاز به برچسبگذاری دادهها، سعی دارد ساختارهای مخفی را در دادهها شناسایی کند. اما چگونه این روش کار میکند؟ چه کاربردهایی دارد؟ و چگونه میتوان از آن برای تحلیل دادهها استفاده کرد؟ در این راهنما، به بررسی مفاهیم اساسی یادگیری بدون نظارت، روشهای آن و کاربردهای عملی آن میپردازیم.
یادگیری بدون نظارت چیست؟
یادگیری بدون نظارت، یک روش در یادگیری ماشین است که در آن الگوریتمها بدون نیاز به دادههای برچسبدار (دادههایی که پاسخ یا خروجی آنها مشخص است)، سعی میکنند ساختارهای پنهان در دادهها را کشف کنند. در مقابل روشهای نظارتشده که نیاز به دادههای برچسبدار دارند، این روش بر اساس شباهتها و تفاوتهای موجود در دادهها، گروهبندیها یا الگوهای جدیدی را شناسایی میکند.
به عنوان مثال، تصور کنید یک مجموعه داده از مشتریان یک فروشگاه را دارید که شامل اطلاعاتی مانند سن، درآمد، ترجیحات خرید و غیره است. در یادگیری بدون نظارت، الگوریتم میتواند بدون اینکه بداند چه گروههایی وجود دارند، مشتریان را به گروههای مشابهی تقسیم کند. این گروهبندیها میتوانند به شرکت کمک کنند تا استراتژیهای بازاریابی هدفمندتری را طراحی کند.
چگونه یادگیری بدون نظارت الگوهای پنهان دادهها را پیدا میکند؟
الگوریتمهای یادگیری بدون نظارت با استفاده از روشهای مختلفی، سعی میکنند ساختارهای پنهان در دادهها را شناسایی کنند. برخی از روشهای رایج شامل:
- کلاسترینگ (Clustering): این روش دادهها را به گروههای مشابه تقسیم میکند. یکی از معروفترین الگوریتمهای کلاسترینگ، الگوریتم K-Means است که دادهها را به K گروه تقسیم میکند تا فاصله بین دادههای یک گروه به حداقل برسد.
- تجزیه و تحلیل مؤلفههای اصلی (PCA): این روش دادهها را به مؤلفههای اصلی تبدیل میکند تا بتوان دادهها را در ابعاد کمتر نمایش داد و دادههای تکراری یا غیرمهم را حذف کرد.
- تجزیه و تحلیل فاکتور (Factor Analysis): این روش سعی میکند دادهها را به متغیرهای زیرین (فاکتور) تبدیل کند که میتوانند روابط پنهان بین دادهها را نشان دهند.
- تجزیه و تحلیل شبکههای عصبی خودکار (Autoencoders): این روش با استفاده از شبکههای عصبی، سعی میکند دادههای ورودی را به صورت فشردهتری نمایش دهد و دادههای اصلی را بازسازی کند.
این الگوریتمها با بررسی شباهتها و تفاوتهای دادهها، سعی میکنند ساختارهای پنهان را شناسایی کنند. برای مثال، در یک مجموعه داده از مشتریان، الگوریتم میتواند گروههایی از مشتریان با ترجیحات مشابه را شناسایی کند یا در دادههای مالی، الگوریتم میتواند الگوی مصرف غیرعادی را تشخیص دهد.
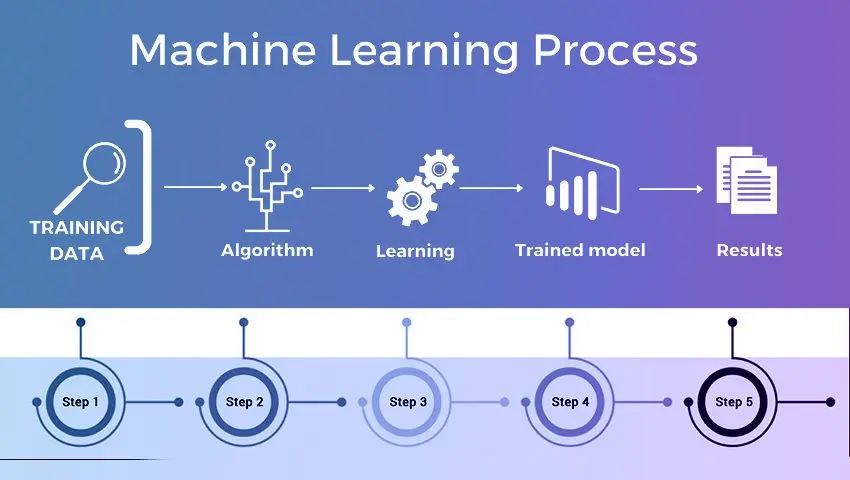
کاربردهای عملی یادگیری بدون نظارت
یادگیری بدون نظارت در بسیاری از حوزهها کاربرد دارد. برخی از کاربردهای مهم آن عبارتند از:
- بازاریابی: شناسایی گروههای مشتری با ترجیحات مشابه برای طراحی استراتژیهای بازاریابی هدفمند.
- بانکداری و مالی: تشخیص فعالیتهای مشکوک یا فرار از پرداخت در تراکنشهای مالی.
- پزشکی: شناسایی الگوهای بیماری در دادههای پزشکی یا گروهبندی بیماران با ویژگیهای مشابه.
- سیستمهای توصیه: پیشنهاد محصولات یا خدمات بر اساس ترجیحات کاربر بدون نیاز به برچسبگذاری دادهها.
- تصویربرداری: تشخیص الگوهای پنهان در تصاویر پزشکی یا تشخیص چهره بدون نیاز به دادههای برچسبدار.
این روش همچنین در حوزههای دیگری مانند تحلیل شبکههای اجتماعی، تشخیص تقلب و حتی در علوم پایه مانند زیستشناسی مولکولی کاربرد دارد.
چگونه از یادگیری بدون نظارت برای تحلیل دادهها استفاده کنیم؟
استفاده از یادگیری بدون نظارت نیازمند درک مفاهیم اساسی و انتخاب روش مناسب است. در این بخش، به برخی از مراحل کلیدی برای شروع کار با این روش میپردازیم:
- شناخت دادهها: قبل از هر چیز، باید دادههای خود را بشناسید. دادههای شما چه نوعی هستند؟ آیا دادههای عددی، کلماتی یا ترکیبی از هر دو هستند؟ این مرحله بسیار مهم است زیرا انتخاب روش مناسب به نوع دادهها بستگی دارد.
- پاکسازی و آمادهسازی دادهها: دادههای ناقص، نامناسب یا دارای خطا میتوانند نتایج را تحت تأثیر قرار دهند. بنابراین، پاکسازی دادهها و آمادهسازی آنها برای تحلیل بسیار مهم است.
- انتخاب الگوریتم مناسب: بسته به هدف شما، باید الگوریتم مناسب را انتخاب کنید. برای مثال، اگر میخواهید دادهها را به گروههای مشابه تقسیم کنید، الگوریتمهای کلاسترینگ مانند K-Means یا DBSCAN مناسب هستند.
- اجرا و ارزیابی: پس از انتخاب الگوریتم، باید آن را اجرا کنید و نتایج را ارزیابی کنید. در یادگیری بدون نظارت، ارزیابی کمی چالشبرانگیز است زیرا دادههای برچسبدار در دسترس نیستند. بنابراین، میتوانید از روشهای بصری یا معیارهای داخلی استفاده کنید.
- تفسیر نتایج: در نهایت، باید نتایج را تفسیر کنید و ببینید چه اطلاعاتی از دادهها استخراج کردهاید. این مرحله بسیار مهم است زیرا بدون تفسیر صحیح، نتایج ممکن است بیفایده باشند.
برای شروع کار با یادگیری بدون نظارت، میتوانید از کتابخانههای مختلفی مانند Scikit-learn در زبان برنامهنویسی Python استفاده کنید. این کتابخانه ابزارهای لازم برای اجرای الگوریتمهای مختلف یادگیری بدون نظارت را فراهم میکند.
چالشهای یادگیری بدون نظارت
در حالی که یادگیری بدون نظارت ابزار قدرتمندی برای کشف الگوهای پنهان در دادهها است، اما با چالشهایی نیز همراه است:
- عدم وجود برچسب: یکی از بزرگترین چالشها این است که دادههای برچسبدار در دسترس نیستند، بنابراین ارزیابی نتایج دشوار است.
- انتخاب پارامترها: در بسیاری از الگوریتمها، انتخاب پارامترهای مناسب مانند تعداد کلاسترها در K-Means، بسیار مهم است و میتواند نتایج را تحت تأثیر قرار دهد.
- مقیاسپذیری: برخی از الگوریتمها برای دادههای بزرگ مقیاسپذیر نیستند و ممکن است نیاز به بهینهسازی داشته باشند.
- تفسیر نتایج: تفسیر نتایج الگوریتمهای بدون نظارت میتواند پیچیده باشد و نیاز به دانش تخصصی دارد.
با این حال، با درک مناسب این چالشها و استفاده از روشهای مناسب، میتوان از یادگیری بدون نظارت برای استخراج اطلاعات ارزشمند از دادهها استفاده کرد.
یادگیری بدون نظارت در دنیای واقعی
یادگیری بدون نظارت در بسیاری از شرکتها و سازمانها برای تحلیل دادهها و کشف الگوهای پنهان استفاده میشود. برای مثال، شرکتهای بزرگ مانند آمازون و نتفلیکس از این روش برای پیشنهاد محصولات و خدمات به کاربران استفاده میکنند. همچنین، در حوزه پزشکی، این روش برای تشخیص بیماریها و تحلیل دادههای ژنتیکی کاربرد دارد.
در دنیای امروزی که دادهها به سرعت در حال افزایش هستند، یادگیری بدون نظارت میتواند ابزار ارزشمندی برای کشف اطلاعات پنهان باشد. با استفاده از این روش، میتوان دادهها را بهتر درک کرد و تصمیمات مبتنی بر داده را بهبود بخشید.
اگر علاقهمند به یادگیری بیشتر در مورد یادگیری بدون نظارت و کاربردهای آن در تحلیل دادهها هستید، میتوانید در مقالات مرتبط دیلی ۲۴ – دیلی ۲۴ به بررسی روشهای مختلف و مثالهای عملی بپردازید.