مدل زبانی بزرگ چیست و چگونه متن شبیه انسان تولید میکند؛ یک راهنمای کامل برای تصمیم بهتر
در چند سال گذشته، یکی از مهمترین پیشرفتهای حوزه هوش مصنوعی، ظهور مدلهای زبانی بزرگ بوده است. این سیستمها با توانایی تولید متنهای پیچیده و شبیه به انسان، توجه بسیاری از کاربران، توسعهدهندگان و حتی متخصصان را به خود جلب کردهاند. اما مدل زبانی بزرگ دقیقاً چیست؟ چگونه کار میکند؟ و چرا توانایی تولید متن شبیه انسان دارد؟ در این راهنما کامل، به این سوالات پاسخ خواهیم داد و همچنین نحوه استفاده از این فناوری برای تصمیمگیری بهتر را بررسی میکنیم.
مدل زبانی بزرگ چیست؟
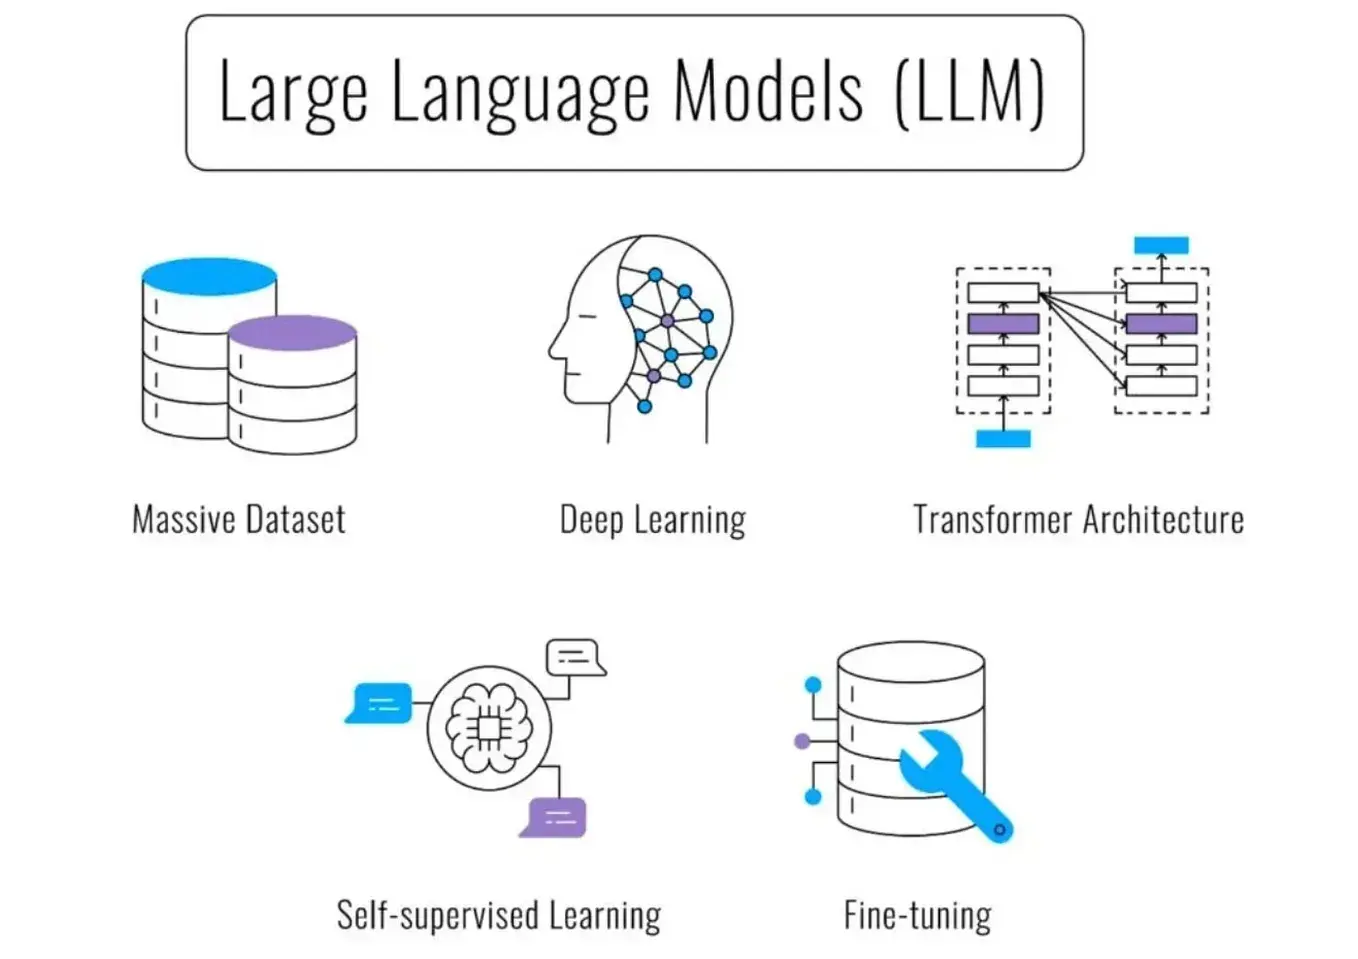
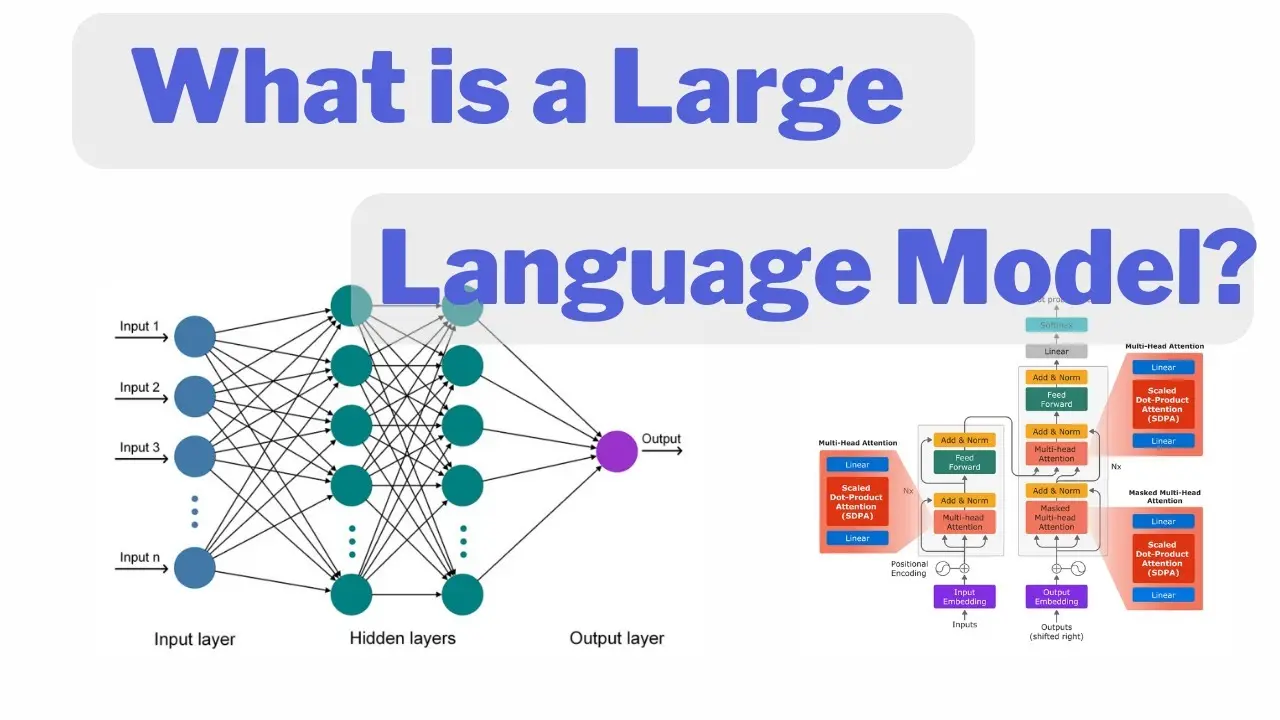
مدلهای زبانی بزرگ (Large Language Models یا LLMs) نوعی از مدلهای هوش مصنوعی هستند که با استفاده از شبکههای عصبی عمیق و حجم عظیم دادههای متن، توانایی درک و تولید زبان انسانی را کسب کردهاند. این مدلها بر اساس معماریهای پیشرفته مانند ترانسفورمر (Transformer) ساخته شدهاند و با آموزش بر روی میلیاردها متن از منابع مختلف، توانایی پیشبینی کلمات بعدی در یک جمله یا حتی تولید متن کامل را پیدا کردهاند.
یکی از ویژگیهای اصلی این مدلها، توانایی فهم زمینه (Context) است. به این معنی که آنها نه تنها کلمات را به صورت جداگانه درک میکنند، بلکه ارتباط بین کلمات، جملهها و حتی پاراگرافها را نیز در نظر میگیرند. این ویژگی باعث میشود که متنهای تولیدی آنها به صورت طبیعی و منطقی به نظر برسد.
چگونه مدلهای زبانی بزرگ متن شبیه انسان تولید میکنند؟
فرآیند تولید متن توسط این مدلها بر اساس چند مرحله کلی انجام میشود:
- آموزش با دادههای بزرگ: مدلها با خواندن میلیاردها متن از کتابها، مقالات، وبسایتها و حتی گفتگوهای آنلاین، الگوهای زبان را یادمیگیرند. این دادهها شامل متنهای مختلف از جمله خبری، ادبی، فنی و علمی هستند.
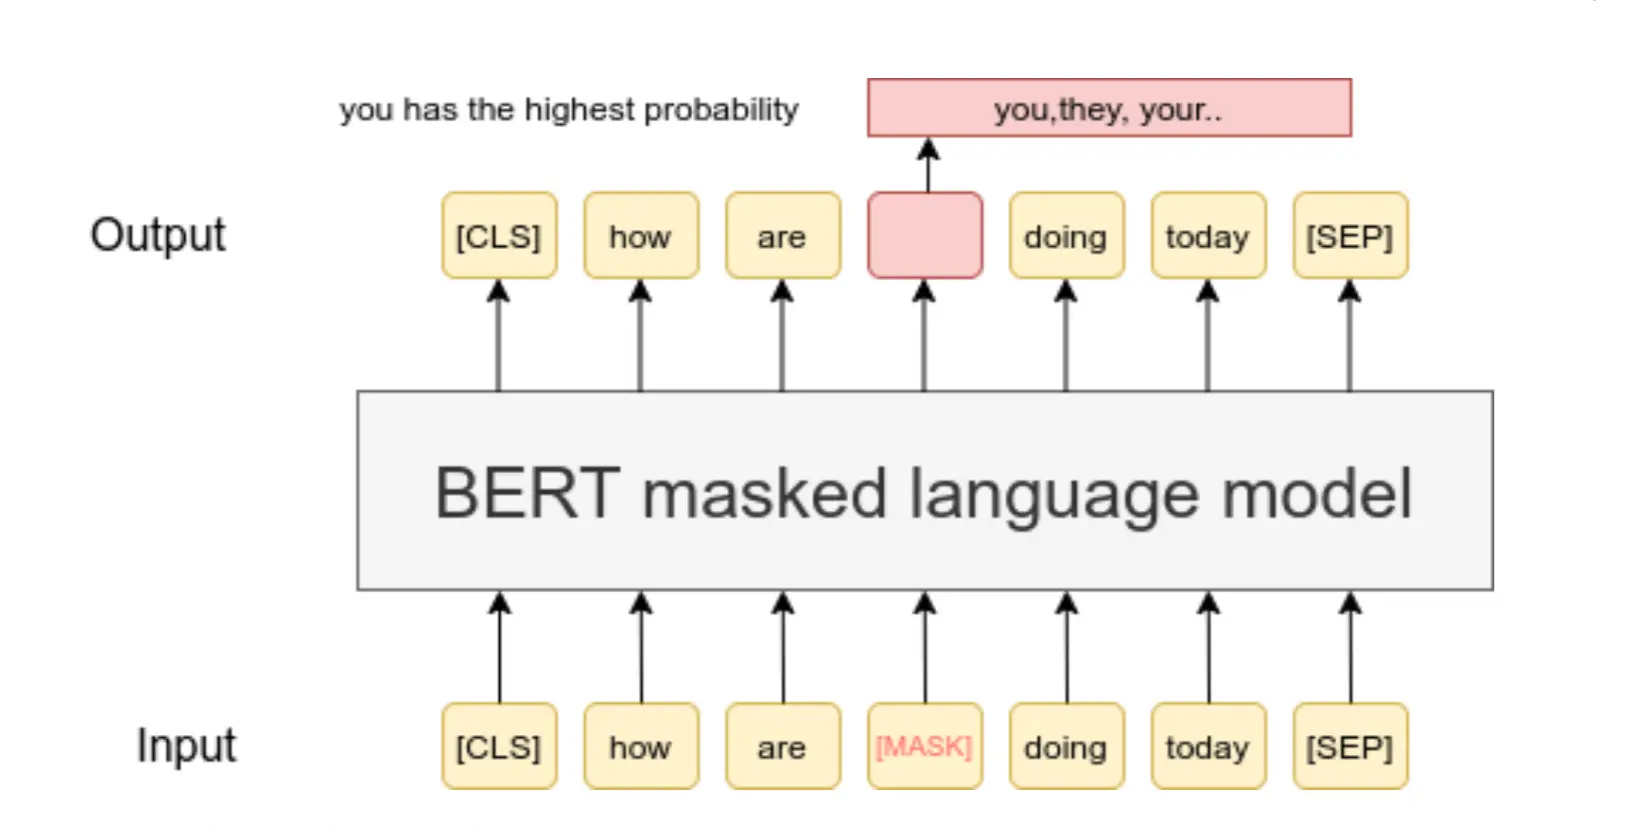
- پیشبینی کلمات: مدلها با استفاده از الگوریتمهای پیشرفته، احتمال کلمات بعدی در یک جمله را بر اساس کلمات قبلی محاسبه میکنند. این کار به صورت تکراری انجام میشود تا متن کامل تولید شود.
- درک زمینه: مدلها با توجه به متنهای قبلی، زمینه را درک میکنند و متن تولیدی را با آن هماهنگ میسازند. این ویژگی باعث میشود که متن نهایی به صورت طبیعی و مرتبط به نظر برسد.
- تنوع و خلاقیت: با استفاده از تکنیکهای مختلف، مدلها سعی میکنند متن تولیدی را متنوع و خلاقانه نگه دارند تا از تکرار و یکنواختی دوری کنند.
این فرآیند به گونهای طراحی شده است که مدل بتواند متنهایی تولید کند که نه تنها از نظر گرامری صحیح باشند، بلکه در سطح معنایی نیز با متنهای انسانی قابل مقایسه باشند.
چرا متن تولیدی این مدلها شبیه به انسان است؟
توانایی تولید متن شبیه انسان در مدلهای زبانی بزرگ به چند عامل اصلی بستگی دارد:
- دادههای متنوع: مدلها با خواندن متنهای مختلف از منابع گوناگون، توانایی درک و تولید متنهای متنوع را کسب میکنند. این متنها شامل گفتگوهای روزمره، مقالات علمی، شعر و حتی کدهای برنامهنویسی هستند.
- الگوریتمهای پیشرفته: معماریهای مانند ترانسفورمر، توانایی مدلها را در درک روابط بین کلمات و جملهها افزایش میدهند. این معماریها به مدل اجازه میدهند تا ارتباطات پیچیده را درک کنند و متنهای مرتبط تولید کنند.
- آموزش با بازخورد: بسیاری از مدلهای زبانی بزرگ با استفاده از بازخوردهای انسانی بهبود مییابند. این بازخوردها میتوانند شامل تصحیح خطاهای گرامری یا معنایی باشند که باعث میشود مدلها در تولید متنهای دقیقتر و طبیعیتر موفقتر شوند.
- پیشبینی احتمالی: مدلها نه تنها کلمهای را پیشبینی میکنند، بلکه احتمال کلمات مختلف را نیز محاسبه میکنند. این ویژگی باعث میشود که متن تولیدی به صورت طبیعی و بدون قاعدهمند بودن به نظر برسد.
با ترکیب این عوامل، مدلهای زبانی بزرگ توانایی تولید متنهایی را دارند که از نظر گرامری، معنایی و حتی سبک نوشتاری، شبیه به متنهای انسانی هستند.
محدودیتهای مدلهای زبانی بزرگ
با وجود تواناییهای قابل توجهی که مدلهای زبانی بزرگ دارند، همچنان محدودیتهایی نیز دارند که باید در نظر گرفته شوند:
- نقص در درک عمیق: این مدلها میتوانند متنهای طبیعی تولید کنند، اما درک عمیق و منطقی از متنها را ندارند. به این معنی که ممکن است اطلاعات نادرست یا غیرمنطقی تولید کنند.
- بازتولید اطلاعات: مدلها نمیتوانند اطلاعات جدید تولید کنند، بلکه بر اساس دادههای موجود، متن تولید میکنند. بنابراین، اگر دادههای آموزشی آنها دارای bias یا اطلاعات نادرست باشند، متن تولیدی نیز تحت تأثیر این موارد قرار میگیرد.
- کمبود زمینه فرهنگی: مدلها ممکن است در درک فرهنگها، سنتها و ارزشهای مختلف دچار مشکل شوند، به خصوص اگر دادههای آموزشی آنها از منابع محدود و یکنواخت باشند.
- نیاز به منابع محاسباتی بالا: آموزش و استفاده از این مدلها نیاز به منابع محاسباتی بسیار زیادی دارد که برای بسیاری از کاربران غیرممکن است.
با این حال، با پیشرفتهای مداوم در این حوزه، بسیاری از این محدودیتها در حال کاهش هستند.
چگونه میتوان از مدلهای زبانی بزرگ برای تصمیمگیری بهتر استفاده کرد؟
مدلهای زبانی بزرگ میتوانند در بسیاری از زمینهها به عنوان ابزاری قدرتمند برای تصمیمگیری بهتر استفاده شوند. برخی از کاربردهای اصلی این مدلها عبارتند از:
- تحلیل دادههای متن: این مدلها میتوانند حجم زیادی از دادههای متن را تحلیل کرده و اطلاعات ارزشمندی را استخراج کنند. برای مثال، در تحلیل احساسات (Sentiment Analysis)، میتوانند نظرات کاربران را بررسی کرده و دیدگاههای عمومی را شناسایی کنند.
- تولید محتوا: از تولید مقالات و گزارشها گرفته تا نوشتن کدهای برنامهنویسی، این مدلها میتوانند در تولید محتواهای مختلف کمک کنند. این کار نه تنها زمان را صرفهجویی میکند، بلکه کیفیت محتوا را نیز بهبود میبخشد.
- پشتیبانی مشتری: چتبوتهای مبتنی بر مدلهای زبانی بزرگ میتوانند به صورت ۲۴ ساعته به سوالات مشتریان پاسخ دهند و تجربه کاربری را بهبود بخشند.
- ترجمه: این مدلها میتوانند متنها را به زبانهای مختلف ترجمه کنند و ارتباط بین فرهنگها را تسهیل کنند.
- تحلیل ریسک: در زمینههای مالی و بیمه، این مدلها میتوانند دادههای متن را تحلیل کرده و ریسکهای احتمالی را شناسایی کنند.
برای استفاده مؤثر از این مدلها، باید به چند نکته توجه کرد:
- انتخاب مدل مناسب: هر مدل برای کاربرد خاصی طراحی شده است. برای مثال، برخی مدلها برای تولید متن مناسبتر هستند، در حالی که برخی دیگر در تحلیل دادهها قویتر عمل میکنند.
- ارزیابی کیفیت متن: همیشه باید کیفیت متن تولیدی توسط مدل را ارزیابی کرد. این ارزیابی میتواند شامل بررسی دقت، طبیعی بودن و مرتبط بودن متن با موضوع باشد.
- کمک گرفتن از متخصصان: در مواردی که تصمیمگیریهای مهمی در دست است، مشاوره با متخصصان مربوطه میتواند بسیار مفید باشد.
- بهروزرسانی مداوم: مدلهای زبانی بزرگ به سرعت در حال پیشرفت هستند. بنابراین، باید از آخرین نسخهها و بهروزرسانیها استفاده کرد.
با توجه به این نکات، میتوان از مدلهای زبانی بزرگ به عنوان یک ابزار قدرتمند برای تصمیمگیری بهتر استفاده کرد.
چالشهای آینده
با پیشرفت مدلهای زبانی بزرگ، چالشهای جدیدی نیز به وجود آمده است. برخی از این چالشها عبارتند از:
- حریم خصوصی دادهها: استفاده از دادههای شخصی برای آموزش این مدلها میتواند خطرات حریم خصوصی را به همراه داشته باشد.
- اثرات اجتماعی: استفاده گسترده از این مدلها ممکن است تأثیرات اجتماعی داشته باشد، مانند تغییر در بازار کار یا تأثیر بر فرهنگ.
- دقت و مسئولیتپذیری: با افزایش استفاده از این مدلها، مسئولیتپذیری در مورد دقت و صحت اطلاعات تولیدی نیز افزایش مییابد.
پیشرفت در این حوزه نیازمند همکاری بین توسعهدهندگان، سیاستگذاران و جامعه است تا بتوانیم از این فناوری به بهترین شکل ممکن استفاده کنیم.
نکات پایانی
مدلهای زبانی بزرگ یکی از مهمترین پیشرفتهای هوش مصنوعی در دهه گذشته هستند. این مدلها با توانایی تولید متن شبیه انسان، در بسیاری از زمینهها کاربردهای گستردهای دارند. اما برای استفاده مؤثر از این فناوری، باید محدودیتها و چالشهای آن را نیز در نظر گرفت.
اگر شما نیز میخواهید از این فناوری برای بهبود تصمیمگیریهای خود استفاده کنید، پیشنهاد میشود با مدلهای مختلف آزمایش کنید و بهترین گزینه را برای نیازهای خود انتخاب کنید. همچنین، برای اطلاعات بیشتر در مورد کاربردهای مختلف هوش مصنوعی و مدلهای زبانی بزرگ، میتوانید به مقالات مرتبط در دیلی 24 مراجعه کنید.
با پیشرفتهای مداوم در این حوزه، آینده مدلهای زبانی بزرگ بسیار روشن به نظر میرسد و میتوان انتظار داشت که در آینده نزدیک، این فناوری در بسیاری از جنبههای زندگی ما تأثیرگذارتر شود.