تبدیل متن به صدا با هوش مصنوعی چگونه انجام میشود؛ پاسخ به پرسشهای مهم
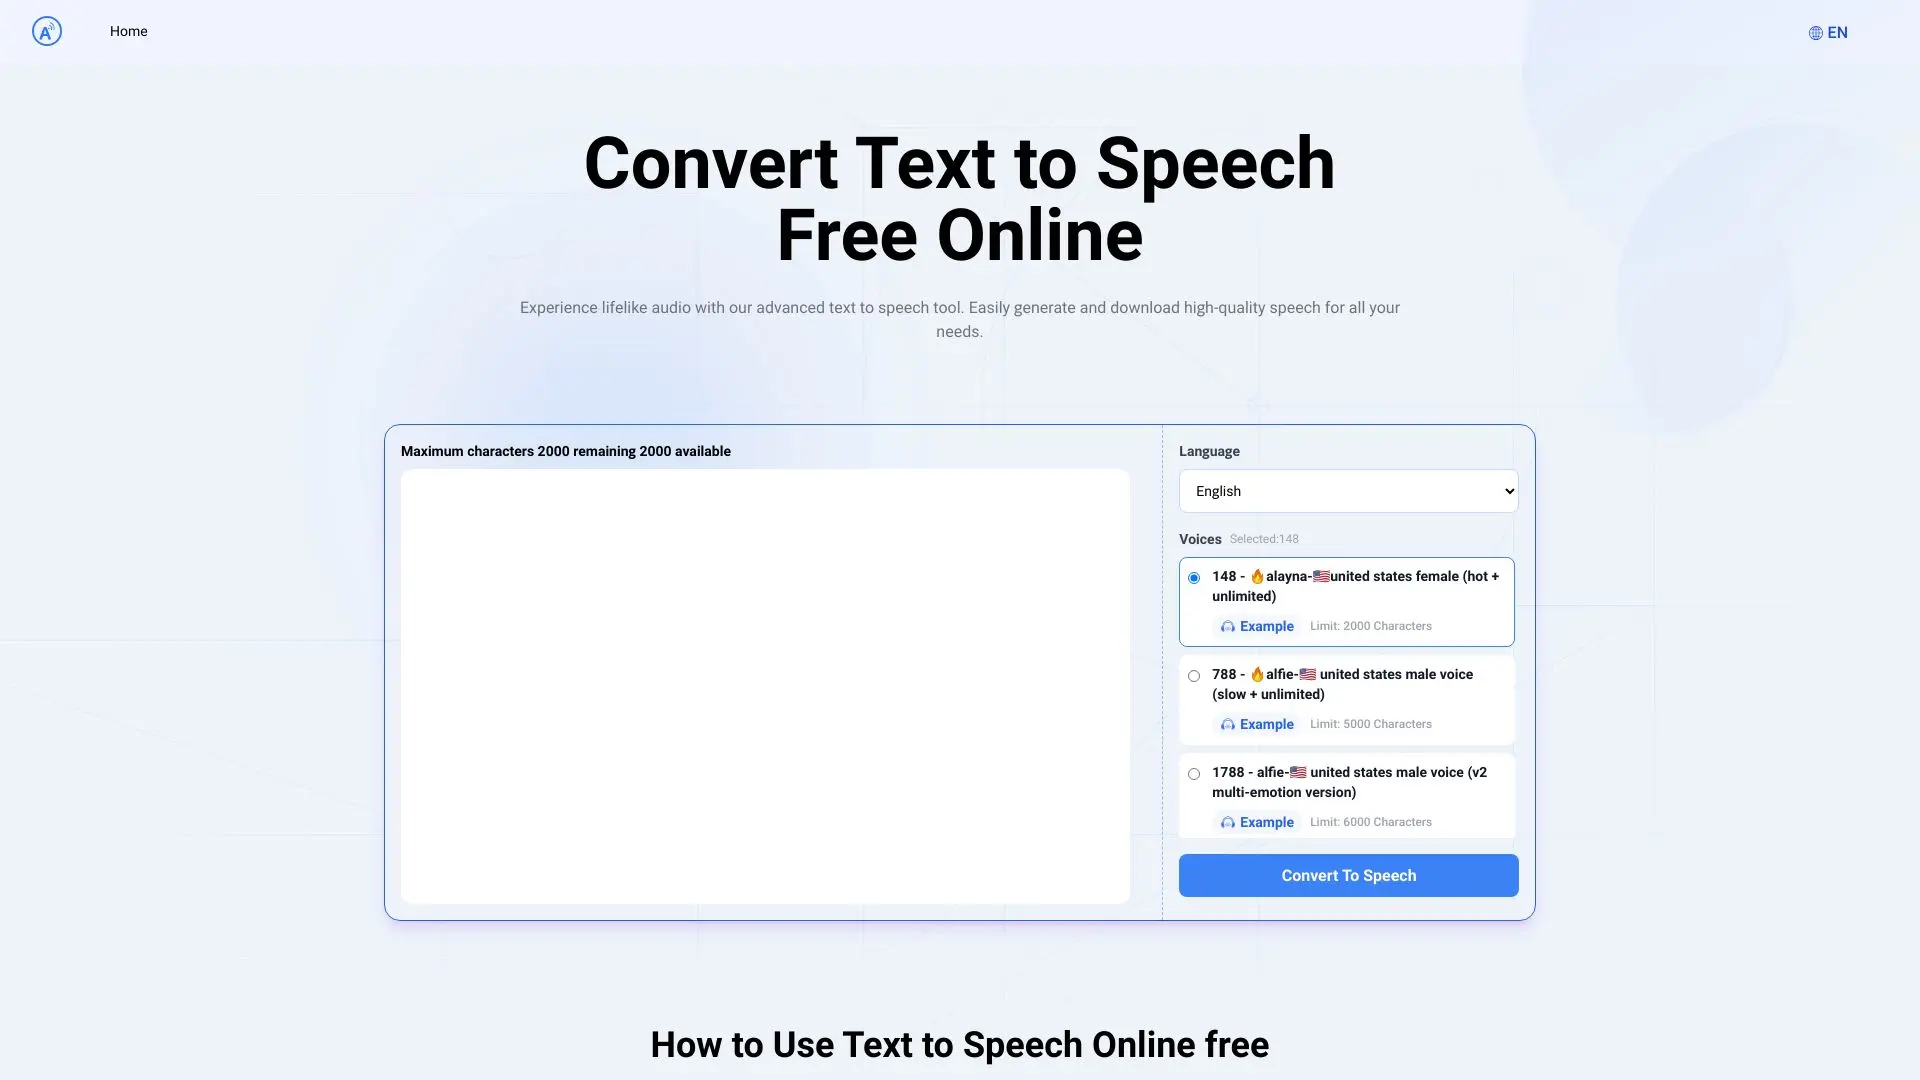
در چند سال گذشته، فناوری تبدیل متن به صدا یا TTS (Text-to-Speech) با پیشرفتهای هوش مصنوعی به یکی از ابزارهای قدرتمند تبدیل شده است. این فناوری امکان خواندن متون نوشته شده توسط کامپیوتر یا دستگاههای هوشمند را با صدای طبیعی یا مصنوعی فراهم میکند. اما چگونه این فرآیند دقیقاً انجام میشود؟ چه چالشهایی در این راه وجود دارد و چه کاربردهایی دارد؟ در این مقاله به بررسی دقیق این فناوری، مراحل تبدیل متن به صدا، انواع مختلف آن و همچنین مزایا و معایب آن میپردازیم.
چگونه هوش مصنوعی متن را به صدا تبدیل میکند؟
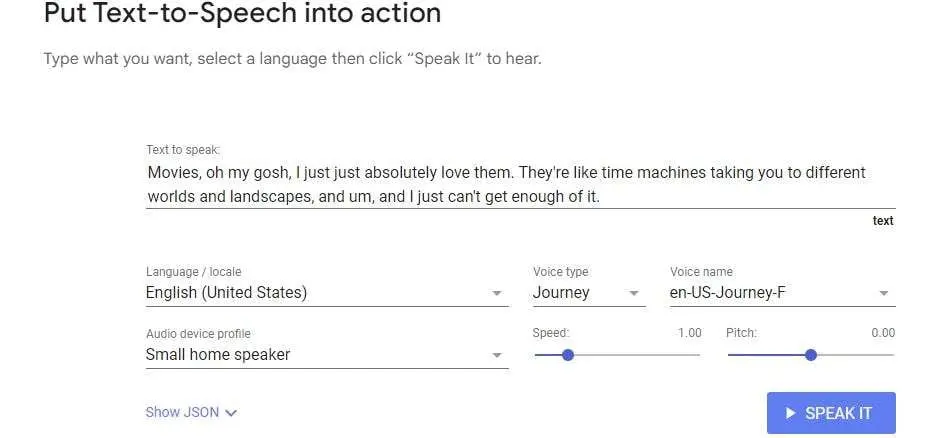
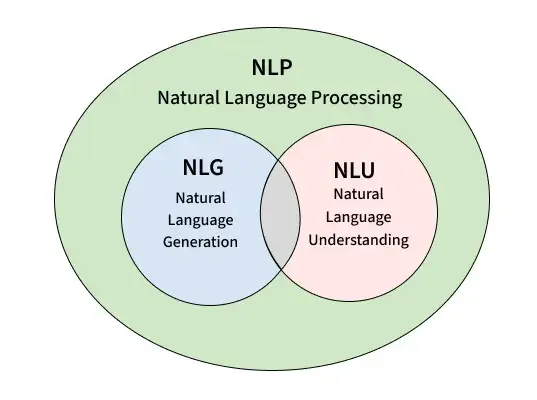
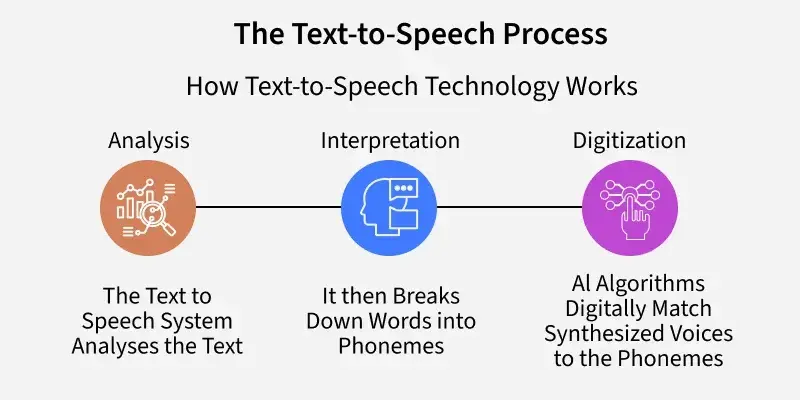
فرآیند تبدیل متن به صدا با استفاده از هوش مصنوعی بر اساس مدلهای پیچیده یادگیری ماشین و پردازش زبان طبیعی (NLP) انجام میشود. این مدلها ابتدا متنی را تحلیل کرده و سپس آن را به سیگنالهای صوتی تبدیل میکنند. در ادامه به مراحل کلی این فرآیند میپردازیم:
۱. پردازش و تحلیل متن
در این مرحله، متن ورودی توسط الگوریتمهای پردازش زبان طبیعی تحلیل میشود. این تحلیل شامل تشخیص نشانهگذاری (tokenization)، تشخیص بخشهای جمله (POS tagging)، و درک معنایی جملهها است. برای مثال، الگوریتم باید تفاوت بین کلمات همصدا مانند “دو” (عدد) و “دو” (فعل) را تشخیص دهد تا صدا به درستی تولید شود.
همچنین، سیستم باید با ابهامهای زبان مانند کلمات چندمعنی یا جملات پیچیده کنار بیاید. برای مثال، کلمه “بانک” ممکن است به معنای مؤسسه مالی یا کنار رودخانه باشد؛ بنابراین، الگوریتم باید با استفاده از زمینه جمله، معنای صحیح را تشخیص دهد.
۲. تبدیل متن به ویژگیهای صوتی
پس از تحلیل متن، الگوریتم باید آن را به ویژگیهای صوتی تبدیل کند. این ویژگیها شامل فرکانس، ریتم، لحن و سایر پارامترهای صوتی هستند. در این مرحله، مدلهای یادگیری عمیق مانند شبکههای عصبی بازگشتی (RNN) یا ترانسفورمرها به کار میروند تا متنی را به یک سری دادههای صوتی تبدیل کنند.
یکی از روشهای رایج در این مرحله استفاده از مدلهای مبتنی بر WaveNet یا Tacotron است. این مدلها با استفاده از دادههای صوتی واقعی آموزش دیده و میتوانند صداهای طبیعیتری تولید کنند.
۳. تولید صدا
در این مرحله، ویژگیهای صوتی به سیگنالهای صوتی واقعی تبدیل میشوند. این فرآیند ممکن است با استفاده از روشهای سنتی مانند سنتز صدا با استفاده از فرکانسهای پایه (Fundamental Frequency) یا روشهای مدرنتر مانند سنتز صدا با استفاده از شبکههای عصبی انجام شود.
یکی از چالشهای اصلی در این مرحله حفظ طبیعی بودن صدا است. برای مثال، صدای تولید شده نباید مانند یک ربات یا دستگاه قدیمی به گوش برسد. بنابراین، مدلها باید با دادههای صوتی واقعی آموزش دیده و بتوانند لحن، ریتم و حتی عواطف را در صدا بازتولید کنند.
انواع مختلف تبدیل متن به صدا
سیستمهای تبدیل متن به صدا به دو دسته اصلی تقسیم میشوند:
- سیستمهای مبتنی بر دیتابیس صدا: این سیستمها از یک دیتابیس پیشتولید شده از صدای انسان استفاده میکنند. برای مثال، کلمات یا جملههای خاصی پیشتولید شده و در زمان نیاز به صورت ترکیبی استفاده میشوند. این روش سریعتر است اما ممکن است صداهای طبیعیتری تولید نکند.
- سیستمهای مبتنی بر سنتز صدا: این سیستمها با استفاده از الگوریتمهای هوش مصنوعی صدا را در زمان واقعی تولید میکنند. این روش امکان تولید صدای طبیعیتر و متنوعتر را فراهم میکند، اما نیاز به منابع محاسباتی بیشتری دارد.
در سالهای اخیر، سیستمهای مبتنی بر یادگیری عمیق مانند Tacotron 2 و WaveRNN توانستهاند صداهای بسیار طبیعیتری تولید کنند. این مدلها با استفاده از دادههای صوتی واقعی آموزش دیده و میتوانند لحن، ریتم و حتی تغییرات صوتی مانند خنده یا گریه را نیز تولید کنند.
کاربردهای تبدیل متن به صدا با هوش مصنوعی
این فناوری در بسیاری از زمینهها کاربرد دارد و روز به روز در حال گسترش است. برخی از کاربردهای مهم آن عبارتند از:
- دسترسیپذیری: برای افراد نابینا یا دارای مشکلات بینایی، تبدیل متن به صدا امکان دسترسی به اطلاعات را فراهم میکند. این فناوری در خوانندههای صفحه (Screen Readers) مانند JAWS یا NVDA استفاده میشود.
- آموزش و یادگیری: در برنامههای آموزشی، تبدیل متن به صدا میتواند به دانشآموزان کمک کند تا متون را به صورت صوتی بشنوند و یاد بگیرند. این روش به ویژه برای کودکان یا افراد با مشکلات یادگیری مفید است.
- محتواهای چندرسانهای: در تولید فیلم، انیمیشن، پادکست و بازیهای ویدئویی، تبدیل متن به صدا برای تولید صدای شخصیتها یا شرحهای صوتی استفاده میشود.
- موتورهای جستجو و دستیارهای صوتی: دستیارهای صوتی مانند Siri، Alexa یا Google Assistant از این فناوری برای پاسخگویی به سوالات کاربران استفاده میکنند.
- ترجمه و دوبله: در سیستمهای ترجمه خودکار، تبدیل متن به صدا میتواند به تولید دوبلههای صوتی کمک کند.
مزایا و معایب تبدیل متن به صدا با هوش مصنوعی
مزایا:
- افزایش دسترسیپذیری برای افراد دارای معلولیت.
- کاهش هزینههای تولید محتواهای صوتی.
- تولید سریع و خودکار محتواهای صوتی.
- امکان شخصیسازی صدا بر اساس نیازهای کاربر.
معایب:
- صداهای تولید شده ممکن است هنوز طبیعی به نظر نرسند.
- نیاز به منابع محاسباتی بالا برای سیستمهای پیشرفته.
- چالشهای حقوقی و اخلاقی در استفاده از صدای افراد بدون اجازه.
- احتمال تولید صداهای غیرطبیعی یا غیرمنطقی در برخی موارد.
چالشهای پیش رو در تبدیل متن به صدا
با وجود پیشرفتهای چشمگیری، هنوز چالشهایی در این زمینه وجود دارد:
- ناتورالیسم صدا: تولید صدای کاملا طبیعی همچنان یک چالش است. مدلها باید بتوانند لحن، ریتم و حتی تغییرات صوتی مانند استرس یا احساسات را به درستی بازتولید کنند.
- پردازش زبانهای مختلف: بسیاری از سیستمهای TTS به زبان انگلیسی متمرکز هستند و برای زبانهای دیگر مانند فارسی، عربی یا چینی هنوز نیاز به بهبود بیشتری دارند.
- حقوقی و اخلاقی: استفاده از صدای افراد بدون اجازه یا تولید صداهای مشابه افراد مشهور ممکن است به چالشهای حقوقی منجر شود.
- سرعت و کارایی: برخی از سیستمهای پیشرفته نیاز به منابع محاسباتی زیادی دارند که ممکن است برای دستگاههای کوچک مناسب نباشد.
پیشرفتهای اخیر در زمینه هوش مصنوعی و یادگیری عمیق نشان میدهد که این چالشها در آینده نزدیک به حل خواهند رسید. برای مثال، مدلهای جدید مانند Whisper از OpenAI یا VALL-E توانستهاند در تولید صدای طبیعیتر و متنوعتر پیشرفت قابل توجهی داشته باشند.
آینده تبدیل متن به صدا
با پیشرفتهای مداوم در هوش مصنوعی، آینده تبدیل متن به صدا بسیار روشن به نظر میرسد. برخی از پیشبینیها شامل:
- تولید صدای کاملا طبیعی که قابل تشخیص از صدای انسان واقعی نباشد.
- پیشرفت در ترجمه و دوبله خودکار با کیفیت بالا.
- استفاده گستردهتر در زمینههای پزشکی، آموزشی و سرگرمی.
- کاهش هزینهها و افزایش دسترسی به این فناوری برای همه.
همچنین، با توجه به نیاز روزافزون به محتواهای صوتی، این فناوری میتواند در تولید پادکستها، کتابهای صوتی و حتی فیلمهای انیمیشن نقش مهمی ایفا کند. برای اطلاعات بیشتر در مورد کاربردهای هوش مصنوعی در تولید محتوا، میتوانید به مقالات مرتبط در دیلی ۲۴ مراجعه کنید.