Robots.txt چیست و چگونه دسترسی رباتها را مدیریت میکند؛ نکات کاربردی و اشتباهات رایج
در دنیای دیجیتال امروز، سایتها با حجم عظیمی از ترافیک روباتی روبرو هستند که میتوانند تأثیرات مثبت یا منفی بر عملکرد و امنیت وبسایت داشته باشند. یکی از ابزارهای اساسی برای مدیریت این رباتها، فایل robots.txt است. این فایل کوچک اما قدرتمند، راهنمایی برای رباتهای جستجوگر و دیگر رباتها فراهم میکند تا بدانند کدام بخشهای سایت را میتوانند crawl کنند و کدام بخشها باید از آنها دور بمانند. در این مقاله، به بررسی دقیقتر این فایل، نحوه عملکرد آن، نکات کاربردی و همچنین اشتباهات رایجی که در استفاده از آن رخ میدهد، میپردازیم.
فایل robots.txt چیست؟
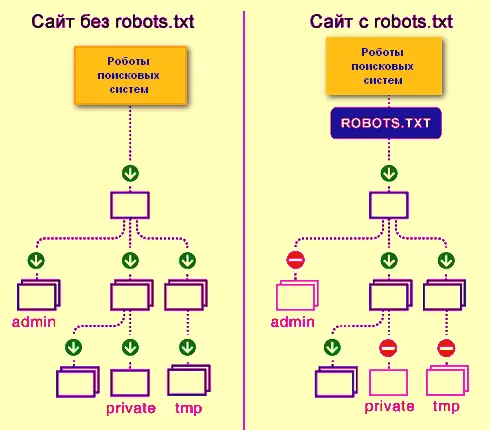
فایل robots.txt یک فایل متنی است که در ریشه دامنه وبسایت قرار میگیرد و به رباتها دستور میدهد که کدام صفحات یا فایلها را نباید crawl کنند. این فایل بر اساس پروتکل Robots Exclusion Protocol (REP) کار میکند و توسط اکثر رباتهای جستجوگر مانند گوگل، بینگ و یاندکس پشتیبانی میشود.
این فایل به وبمسترها این امکان را میدهد که:
- از crawl شدن صفحات خاصی جلوگیری کنند (مانند صفحات شخصی، صفحات در حال توسعه یا صفحات با محتوای حساس).
- محدودیتهایی برای تعداد درخواستهای رباتها در یک بازه زمانی مشخص اعمال کنند.
- دسترسی رباتها به فایلهای خاصی مانند تصاویر، فایلهای PDF یا فایلهای CSS را محدود کنند.
- از بارگذاری بیش از حد سرور جلوگیری کنند.
با این حال، باید توجه داشت که robots.txt تنها یک راهنمایی است و رباتها میتوانند آن را نادیده بگیرند. برای محدودیتهای جدیتر، باید از روشهای دیگری مانند noindex یا محدودیتهای سرور استفاده کرد.
چگونه فایل robots.txt کار میکند؟
فایل robots.txt با استفاده از دستورالعملهای خاصی کار میکند. این دستورالعملها شامل موارد زیر هستند:
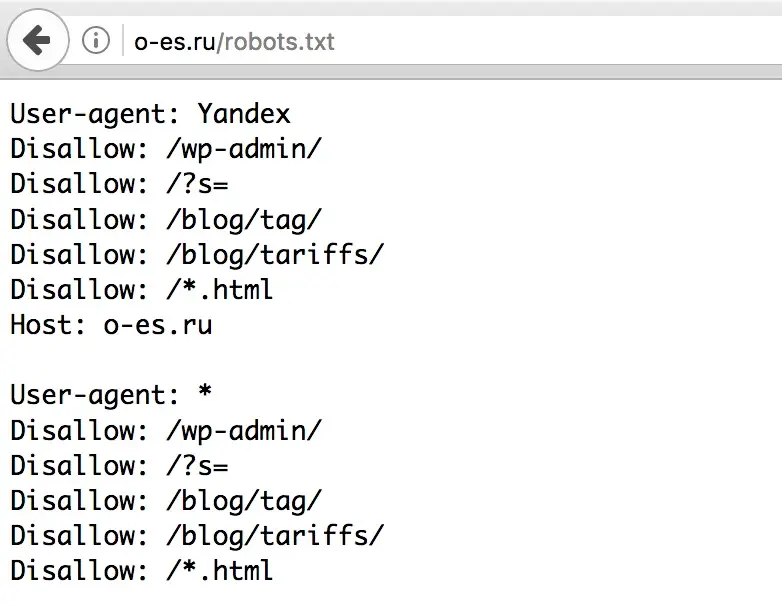
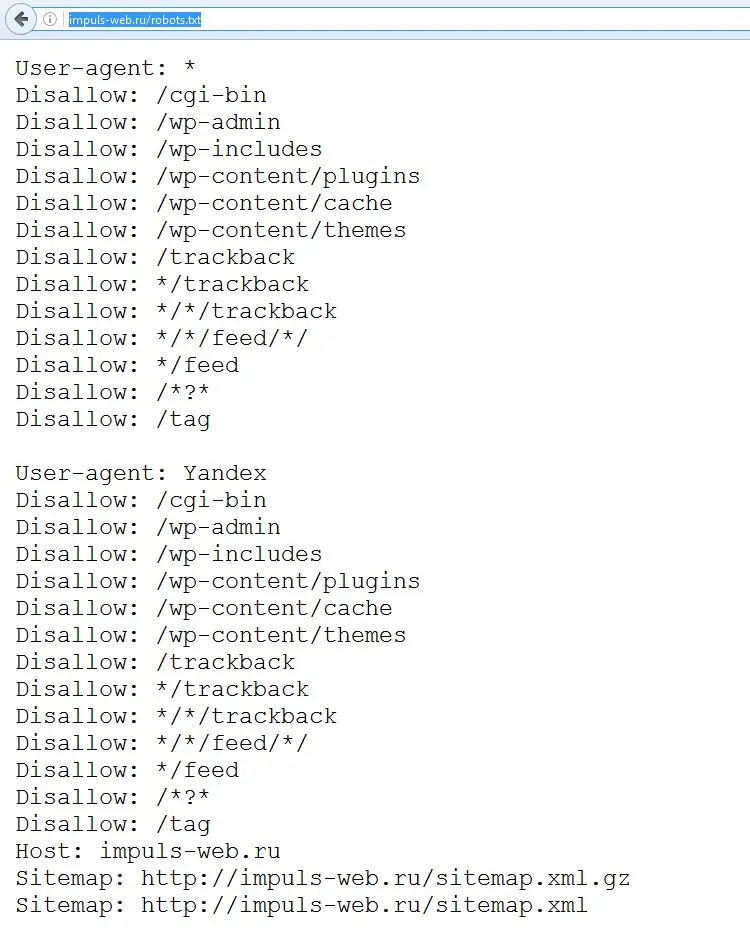
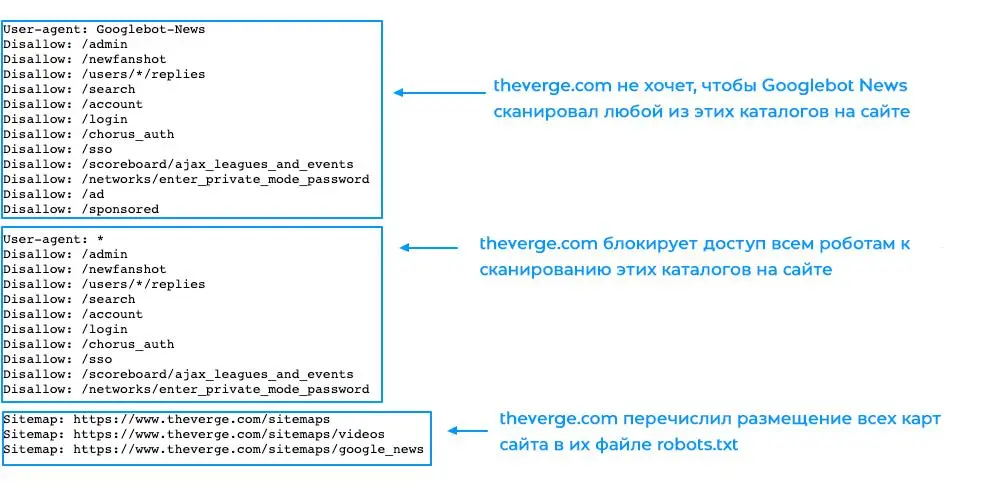
User-agent:مشخص میکند که دستورالعملها برای کدام رباتها اعمال میشود. برای مثال،User-agent: *نشان میدهد که دستورالعملها برای همه رباتها اعمال میشود.Disallow:مشخص میکند که کدام مسیرها نباید توسط ربات crawl شوند. برای مثال،Disallow: /private/نشان میدهد که رباتها نباید پوشه/private/را crawl کنند.Allow:اجازه میدهد که مسیرهای خاصی حتی اگر در یک مسیرDisallowقرار داشته باشند، crawl شوند. برای مثال،Allow: /public/نشان میدهد که پوشه/public/حتی اگر در یک مسیر ممنوعه قرار داشته باشد، crawl شود.Crawl-delay:تأخیر زمانی را برای رباتها مشخص میکند تا از بارگذاری بیش از حد سرور جلوگیری شود. برای مثال،Crawl-delay: 5نشان میدهد که رباتها باید بین هر درخواست، ۵ ثانیه صبر کنند.
برای مثال، یک فایل robots.txt ممکن است به این شکل باشد:
User-agent: *
Disallow: /temp/
Disallow: /private/
Allow: /public/
Crawl-delay: 10
در این مثال، رباتها نمیتوانند پوشههای /temp/ و /private/ را crawl کنند، اما پوشه /public/ اجازه crawl شدن دارد و رباتها باید بین هر درخواست، ۱۰ ثانیه صبر کنند.
نکات کاربردی در استفاده از robots.txt
استفاده صحیح از فایل robots.txt میتواند تأثیر زیادی بر SEO و عملکرد سایت داشته باشد. در این بخش، به برخی از نکات کاربردی اشاره میکنیم:
- از بلوک کردن صفحات مهم خودداری کنید: اگر صفحات مهم سایت مانند صفحه اصلی یا صفحات محصولات را با
Disallowمحدود کنید، ممکن است رباتهای جستجوگر نتوانند آنها را crawl کنند و این میتواند بر رتبهبندی سایت در موتورهای جستجو تأثیر منفی بگذارد. - از استفاده از
robots.txtبرای محافظت از محتوای حساس خودداری کنید: این فایل تنها یک راهنمایی است و رباتها میتوانند آن را نادیده بگیرند. برای محافظت از محتوای حساس، باید از روشهای دیگری مانند احراز هویت یا رمزگذاری استفاده کرد. - از ساختار صحیح استفاده کنید: فایل
robots.txtباید در ریشه دامنه قرار گیرد و باید بدون خطا و با ساختار صحیح نوشته شود. هر خطای کوچک میتواند باعث شود رباتها فایل را درک نکنند. - از ابزارهای تست استفاده کنید: قبل از اعمال تغییرات، میتوانید از ابزارهای تست مانند ابزار تست رباتهای گوگل استفاده کنید تا مطمئن شوید که فایل به درستی کار میکند.
- به روزرسانیهای منظم: با تغییرات در سایت، ممکن است نیاز به به روزرسانی فایل
robots.txtداشته باشید. به روزرسانی منظم این فایل میتواند از مشکلات احتمالی جلوگیری کند.
اشتباهات رایج در استفاده از robots.txt
در استفاده از فایل robots.txt، اشتباهات رایجی وجود دارد که میتواند تأثیر منفی بر سایت داشته باشد. برخی از این اشتباهات عبارتند از:
- بلوک کردن صفحات مهم: یکی از اشتباهات رایج، بلوک کردن صفحات مهم مانند صفحه اصلی یا صفحات محصولات است. این کار میتواند باعث کاهش رتبهبندی سایت در موتورهای جستجو شود.
- استفاده از مسیرهای نادرست: استفاده از مسیرهای نادرست یا اشتباه در فایل
robots.txtمیتواند باعث شود رباتها صفحات مورد نظر را crawl نکنند یا صفحات غیرمورد نظر را crawl کنند. - نوشتن دستورالعملهای نامشخص: نوشتن دستورالعملهایی که برای رباتها قابل درک نیستند، میتواند باعث شود فایل به درستی عمل نکند. برای مثال، استفاده از مسیرهای نسبی یا نامشخص.
- عدم تست قبل از اعمال: اعمال تغییرات بدون تست میتواند باعث مشکلاتی شود. همیشه قبل از اعمال تغییرات، باید از ابزارهای تست استفاده کرد.
- استفاده از
robots.txtبرای محدودیتهای امنیتی: این فایل تنها یک راهنمایی است و نمیتواند جایگزین روشهای امنیتی مانند احراز هویت یا رمزگذاری شود.
برای جلوگیری از این اشتباهات، باید به دقت فایل robots.txt را نوشت و قبل از اعمال تغییرات، آن را تست کرد.
چگونه فایل robots.txt را ایجاد و ویرایش کنیم؟
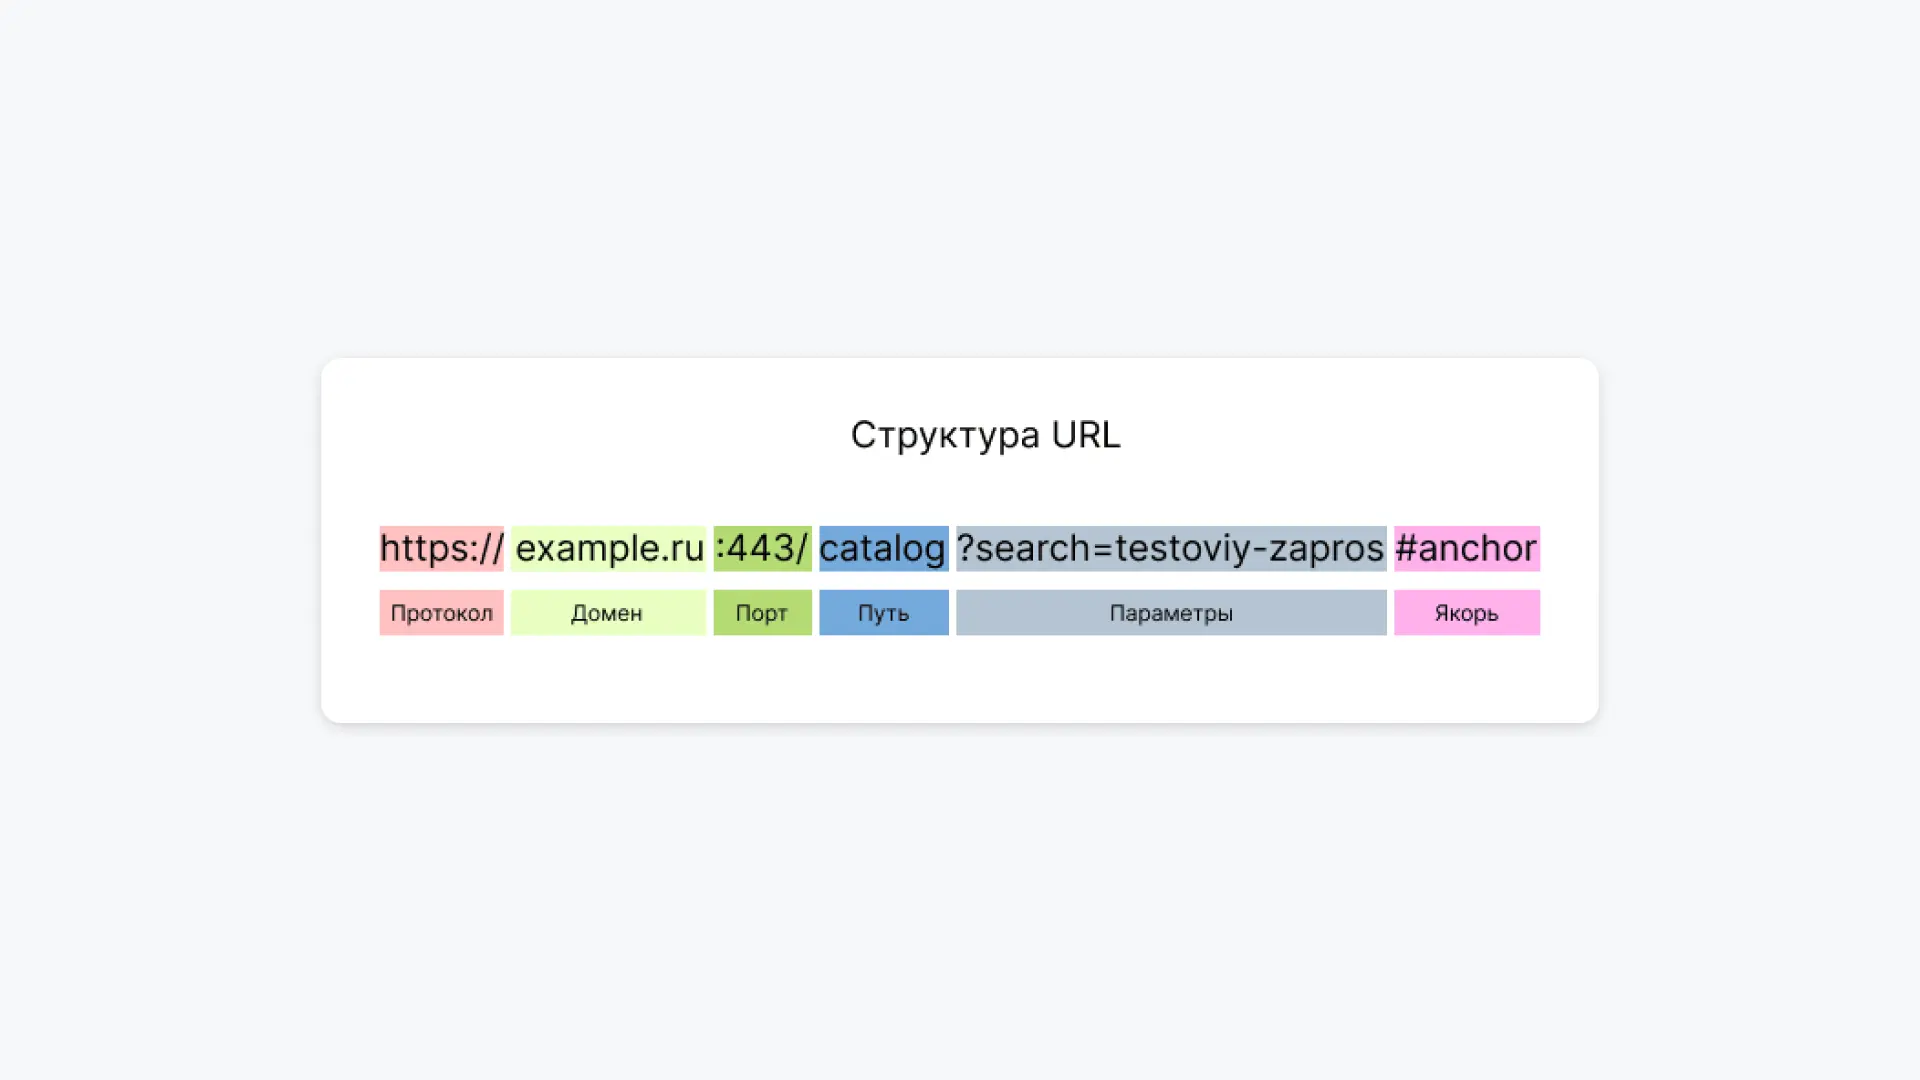
ایجاد و ویرایش فایل robots.txt بسیار ساده است. میتوانید با استفاده از یک ویرایشگر متنی مانند Notepad یا VS Code، فایل را ایجاد کنید و سپس آن را در ریشه دامنه خود آپلود کنید. برای مثال، اگر سایت شما در https://www.example.com قرار دارد، فایل باید در https://www.example.com/robots.txt قرار گیرد.
برای ویرایش فایل، میتوانید از روشهای زیر استفاده کنید:
- با استفاده از FTP یا cPanel، فایل را دانلود، ویرایش و دوباره آپلود کنید.
- از پلاگینهای مدیریت سایت مانند Yoast SEO برای وردپرس استفاده کنید که امکان ویرایش مستقیم فایل
robots.txtرا فراهم میکنند. - از ابزارهای آنلاین مانند ابزارهای تولید فایل robots.txt استفاده کنید.
پس از ویرایش، باید فایل را تست کنید تا مطمئن شوید که به درستی کار میکند.
نتیجهگیری
فایل robots.txt یکی از ابزارهای اساسی برای مدیریت دسترسی رباتها به سایت است. با استفاده صحیح از این فایل، میتوانید از crawl شدن صفحات غیرمورد نظر جلوگیری کنید، بار سرور را کاهش دهید و عملکرد سایت را بهبود بخشید. با این حال، باید توجه داشت که این فایل تنها یک راهنمایی است و نمیتواند جایگزین روشهای امنیتی یا محدودیتهای جدیتر باشد.
برای اطلاعات بیشتر در مورد مدیریت سایت و ابزارهای دیجیتال، میتوانید به مقالات مرتبط در دیلی 24 مراجعه کنید.