مدیریت ریسک مدل چیست و چگونه خطاهای سیستمهای هوشمند ارزیابی میشوند؛ یک راهنمای کامل برای تصمیم بهتر
در دنیای امروز، جایی که سیستمهای هوشمند و الگوریتمهای یادگیری ماشین در بسیاری از تصمیمگیریهای تجاری، مالی و حتی اجتماعی نقش کلیدی ایفا میکنند، مدیریت ریسک مدل به یکی از مهمترین چالشهای سازمانها تبدیل شده است. اما مدیریت ریسک مدل دقیقاً چیست؟ چگونه میتوان خطاهای این سیستمها را شناسایی و ارزیابی کرد؟ و چه روشهایی برای تصمیمگیری بهتر وجود دارد؟ در این راهنمای کامل، به بررسی مفاهیم اساسی، روشهای ارزیابی خطا و راهکارهای عملی برای مدیریت ریسک مدل میپردازیم.
مدیریت ریسک مدل: تعریف و اهمیت
مدیریت ریسک مدل به فرایندی گفته میشود که در آن سازمانها سعی میکنند ریسکهای مرتبط با استفاده از مدلهای پیشبینیکننده، مانند مدلهای مالی، بازاریابی یا تولیدی، را شناسایی، اندازهگیری، کنترل و کاهش دهند. این فرایند شامل ارزیابی دقت مدل، شناسایی خطاهای احتمالی، بررسی حساسیت مدل به تغییرات دادهها و در نهایت تصمیمگیری بر اساس نتایج قابل اعتماد است.
چرا این موضوع اهمیت دارد؟ زیرا مدلهای هوشمند بر اساس دادههای تاریخی و الگوریتمهای پیچیده کار میکنند و اگر دادهها ناقص، نادرست یا بیطرفانه نباشند، نتایج آنها نیز دچار خطا میشوند. برای مثال، یک مدل پیشبینی قیمت سهام که بر اساس دادههای ناکافی یا غیرقابل اعتماد ساخته شده باشد، ممکن است تصمیمات مالی اشتباه را به دنبال داشته باشد. همین موضوع در زمینههای دیگری مانند تشخیص بیماری با استفاده از هوش مصنوعی یا مدیریت زنجیره تأمین نیز صدق میکند.
در واقع، مدیریت ریسک مدل به سازمانها کمک میکند تا:
- از تصمیمگیریهای نادرست جلوگیری کنند.
- کارایی و دقت مدلها را بهبود بخشند.
- به قوانین و استانداردهای صنعتی و مالی پایبند باشند.
- از بروز خسارات مالی یا reputational جلوگیری کنند.
خطاهای سیستمهای هوشمند و چگونگی شناسایی آنها
سیستمهای هوشمند، مانند مدلهای یادگیری ماشین، ممکن است دچار انواع مختلفی از خطا شوند. شناخت این خطاها اولین گام برای مدیریت ریسک مدل است. برخی از رایجترین انواع خطاهای مدل عبارتند از:
- خطای سیستماتیک (Systematic Error): این نوع خطا زمانی رخ میدهد که مدل بهطور مداوم و یکسان نتایج نادرستی تولید کند. برای مثال، اگر یک مدل قیمتگذاری همیشه قیمتها را زیر یا بالاتر از ارزش واقعی نشان دهد، دچار خطای سیستماتیک است.
- خطای تصادفی (Random Error): این خطا به دلیل نویز یا تغییرات غیرقابل پیشبینی در دادهها رخ میدهد و معمولاً با افزایش حجم دادهها کاهش مییابد.
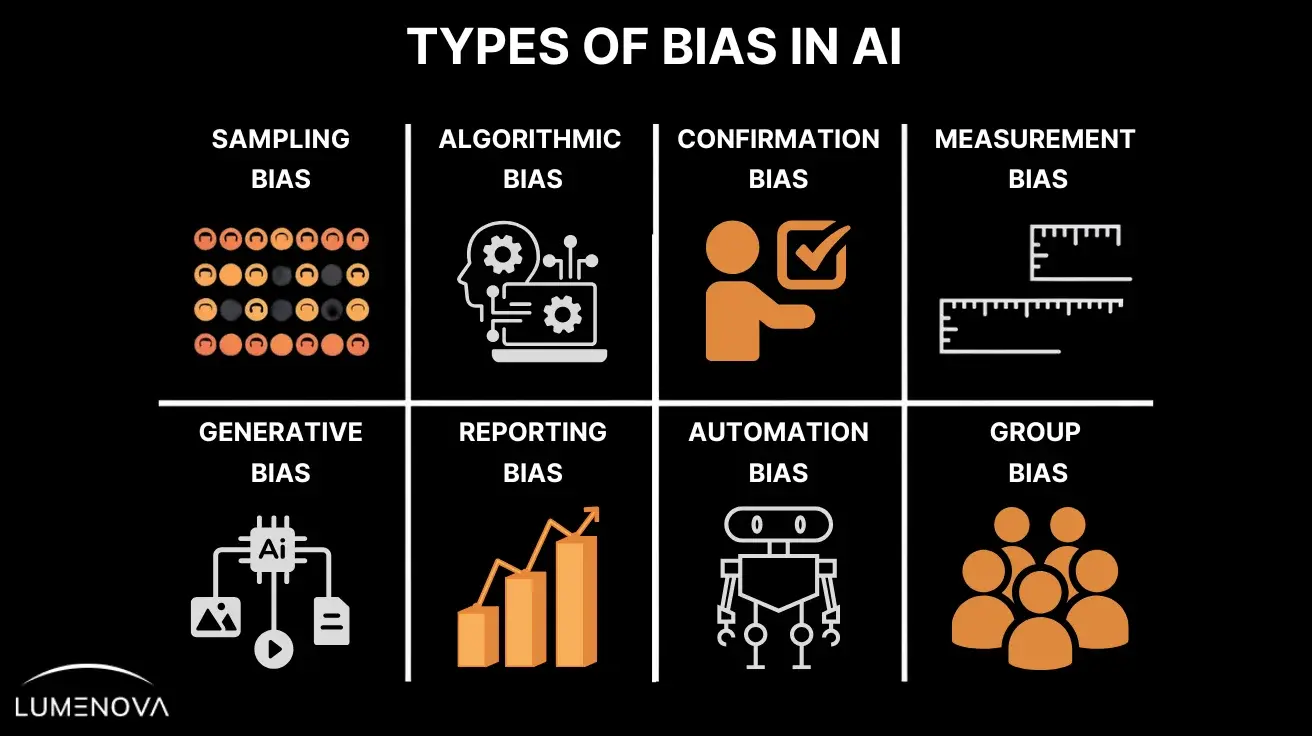
- خطای نمونهبرداری (Sampling Error): زمانی که دادههای آموزشی مدل نمایندهای از جمعیت واقعی نیستند، این نوع خطا رخ میدهد. برای مثال، اگر یک مدل تشخیص بیماری با دادههای بیمارانی آموزش دیده باشد که فقط از یک منطقه خاص هستند، ممکن است در تشخیص بیماران از مناطق دیگر دچار خطا شود.
- خطای مدل (Model Error): این خطا زمانی رخ میدهد که ساختار مدل مناسب دادهها نباشد. برای مثال، استفاده از یک مدل خطی برای دادههای غیرخطی میتواند منجر به خطاهای قابل توجهی شود.
- خطای داده (Data Error): دادههای نادرست، ناقص یا ناپایدار میتوانند منجر به نتایج نادرست شوند. برای مثال، دادههای قدیمی یا دادههایی که از منابع غیرقابل اعتماد گرفته شدهاند، میتوانند مدل را به اشتباه بکشند.
برای شناسایی این خطاها، سازمانها میتوانند از روشهای مختلفی مانند:
- تحلیل دادهها و شناسایی انحرافات.
- استفاده از تکنیکهای ارزیابی مدل مانند معیارهای دقت (Accuracy)، دقت (Precision)، حساسیت (Recall) و F1-score.
- آزمایشهای حساسیت (Sensitivity Analysis) برای بررسی تأثیر تغییرات در ورودیها بر خروجی مدل.
- استفاده از روشهای تشخیص خطا مانند تحلیل باقیماندهها (Residual Analysis).
ارزیابی خطاهای مدل با استفاده از معیارهای آماری
یکی از روشهای اصلی برای ارزیابی دقت مدلها، استفاده از معیارهای آماری است. این معیارها به سازمانها کمک میکنند تا بفهمند مدل چقدر دقیق است و چه نوع خطاهایی ممکن است داشته باشد. برخی از معیارهای مهم عبارتند از:
- مجموعه مربع خطا (MSE) و ریشه مجموع مربع خطا (RMSE): این معیارها میزان خطا بین پیشبینی مدل و ارزش واقعی را اندازهگیری میکنند. RMSE به ویژه برای مدلهای پیشبینیکننده مانند مدلهای مالی بسیار مهم است.
- دقت (Accuracy): درصد پیشبینیهای صحیح مدل نسبت به کل پیشبینیها. این معیار برای مدلهای طبقهبندی بسیار کاربردی است.
- دقت (Precision) و حساسیت (Recall): این معیارها در مدلهای طبقهبندی استفاده میشوند و نشان میدهند که مدل چقدر موفق است در شناسایی موارد مثبت واقعی (Recall) و چقدر از مواردی که پیشبینی مثبت کرده است، صحیح بودهاند (Precision).
- معیار AUC-ROC: این معیار نشان میدهد که مدل چقدر موفق است در تشخیص بین کلاسهای مختلف، به ویژه در مدلهای طبقهبندی دودویی.
استفاده از این معیارها به سازمانها کمک میکند تا بفهمند مدلشان در چه شرایطی دچار خطا میشود و چگونه میتوانند آن را بهبود بخشند. برای مثال، اگر یک مدل تشخیص بیماری دارای حساسیت پایین است، ممکن است بسیاری از موارد مثبت را تشخیص ندهد، در حالی که اگر دقت آن پایین است، ممکن است بسیاری از موارد منفی را به اشتباه مثبت تشخیص دهد.
راهکارهای مدیریت ریسک مدل برای تصمیمگیری بهتر
پس از شناسایی خطاهای احتمالی و ارزیابی دقت مدل، گام بعدی مدیریت ریسک مدل است. در این بخش، به برخی از راهکارهای عملی برای کاهش ریسک و بهبود تصمیمگیری میپردازیم:
1. انتخاب مدل مناسب
انتخاب مدل مناسب بر اساس نوع دادهها و هدف سازمان بسیار مهم است. برای مثال:
- برای دادههای خطی، مدلهای رگرسیون ساده یا چندگانه مناسب هستند.
- برای دادههای پیچیده و غیرخطی، مدلهای درخت تصمیم، شبکههای عصبی یا ماشین بردار پشتیبانی (SVM) میتوانند انتخاب بهتری باشند.
- برای دادههای زمانی، مدلهای سری زمانی مانند ARIMA یا LSTM مناسبتر هستند.
همچنین، سازمانها باید مدلهایی را انتخاب کنند که قابل تفسیر باشند، به ویژه در زمینههای حساس مانند پزشکی یا مالی. مدلهای interpretable مانند درخت تصمیم یا رگرسیون لوجیستیک به کاربران کمک میکنند تا بفهمند چرا مدل به یک نتیجه رسیده است.
2. دادههای با کیفیت و نماینده
دادههای با کیفیت و نماینده یکی از اساسیترین عوامل در دقت مدل هستند. سازمانها باید:
- دادههای خود را تمیز و بدون خطا نگه دارند.
- از دادههای قدیمی یا غیرقابل اعتماد استفاده نکنند.
- دادههای آموزشی را بهطور تصادفی و نماینده از جمعیت واقعی انتخاب کنند.
- از تکنیکهای پیشپردازش داده مانند نرمالسازی، حذف نویز و تکمیل دادههای ناقص استفاده کنند.
استفاده از دادههای با کیفیت پایین میتواند منجر به مدلهایی شود که نتایج نادرست تولید میکنند و در نتیجه تصمیمگیریهای اشتباه را به دنبال داشته باشند.
3. آزمایش و ارزیابی مداوم
مدلهای هوشمند باید بهطور مداوم آزمایش و ارزیابی شوند تا از دقت و کارایی آنها اطمینان حاصل شود. این فرایند شامل:
- آزمایش مدل با دادههای جدید و ناشناخته (Test Data).
- بررسی عملکرد مدل در شرایط واقعی (Real-world Validation).
- بهروزرسانی مداوم مدل با دادههای جدید.
- استفاده از روشهای cross-validation برای ارزیابی دقت مدل.
آزمایش مداوم به سازمانها کمک میکند تا خطاهای احتمالی را زودتر شناسایی و مدل را بهبود بخشند.
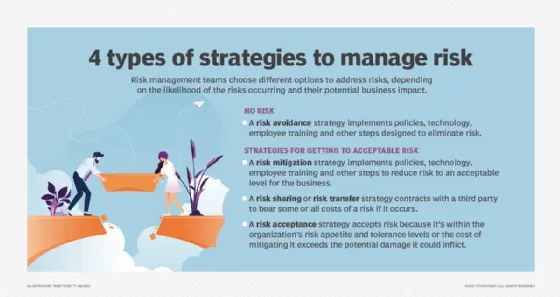
4. استفاده از روشهای کاهش ریسک
سازمانها میتوانند از روشهای مختلفی برای کاهش ریسک مدل استفاده کنند، مانند:
- تکثیر مدل (Model Ensemble): استفاده از چندین مدل برای پیشبینی و سپس ترکیب نتایج آنها میتواند دقت کلی را افزایش دهد.
- استفاده از روشهای robust: مدلهایی که نسبت به نویز و انحرافات در دادهها مقاوم هستند، مانند مدلهای رگرسیون robust.
- ارزیابی ریسک با استفاده از سناریوهای مختلف: بررسی چگونگی عملکرد مدل در شرایط مختلف و سناریوهای احتمالی.
5. پیادهسازی چارچوب مدیریت ریسک مدل
سازمانها میتوانند با پیادهسازی یک چارچوب مدیریت ریسک مدل، فرآیندهای خود را سازماندهی و بهبود بخشند. این چارچوب ممکن است شامل:
- تعیین مسئولیتها و نقشها برای مدیریت ریسک مدل.
- تعیین معیارهای ارزیابی و گزارشدهی.
- پیادهسازی روشهای کنترل کیفیت داده.
- بررسی منظم عملکرد مدلها و گزارش خطاهای احتمالی.
پیادهسازی چنین چارچوبی به سازمانها کمک میکند تا فرآیند مدیریت ریسک مدل را بهطور سیستماتیک و قابل کنترل انجام دهند.
چالشها و بهترین راهکارها
مدیریت ریسک مدل با چالشهایی همراه است که سازمانها باید به آنها توجه کنند. برخی از این چالشها عبارتند از:
- پیچیدگی مدلها: مدلهای پیچیده مانند شبکههای عصبی عمیق ممکن است بسیار دقیق باشند، اما تفسیر آنها دشوار است. این موضوع میتواند در تصمیمگیریهای حساس مشکلساز باشد.
- تغییرات دادهها: دادهها با گذشت زمان تغییر میکنند و مدلها باید بهطور مداوم بهروزرسانی شوند.
- محدودیتهای محاسباتی: برخی از مدلها نیاز به منابع محاسباتی زیادی دارند که برای سازمانهای کوچک ممکن است غیرممکن باشد.
- عدم شفافیت: برخی از مدلها مانند شبکههای عصبی عمیق به عنوان “کجبوک” (Black Box) شناخته میشوند و کاربران نمیدانند چرا مدل به یک نتیجه رسیده است.
برای مقابله با این چالشها، سازمانها میتوانند:
- از مدلهای interpretable استفاده کنند.
- فرآیندهای خود را برای بهروزرسانی مداوم مدلها سازماندهی کنند.
- از منابع محاسباتی مناسب استفاده کنند یا به خدمات ابری متکی باشند.
- از روشهای توضیحپذیری (Explainability) مانند SHAP یا LIME استفاده کنند تا بتوانند عملکرد مدل را تفسیر کنند.
در نهایت، مدیریت ریسک مدل یک فرایند مداوم است که نیاز به توجه و سرمایهگذاری دارد. سازمانهایی که موفق به مدیریت ریسک مدل میشوند، میتوانند از تصمیمگیریهای دقیقتر و کاهش خسارات احتمالی برخوردار شوند.
نتیجهگیری
مدیریت ریسک مدل یکی از مهمترین جنبههای استفاده از سیستمهای هوشمند در سازمانها است. شناسایی خطاهای مدل، ارزیابی دقت آنها و پیادهسازی راهکارهای مناسب برای کاهش ریسک، کلید تصمیمگیریهای بهتر و کاهش خسارات احتمالی است. با استفاده از روشهای مناسب، سازمانها میتوانند از مدلهای هوشمند بهطور مؤثر استفاده کنند و در عین حال از ریسکهای مرتبط با آنها محافظت کنند.
اگر به دنبال اطلاعات بیشتر در زمینه مدیریت ریسک مدل و راهکارهای عملی برای بهبود تصمیمگیری با استفاده از سیستمهای هوشمند هستید، میتوانید در دیلی ۲۴ مقالات مرتبط دیگر را مطالعه کنید.