دستیار صوتی هوشمند چگونه صدای انسان را تشخیص میدهد؛ بررسی نکات و جزئیات مهم
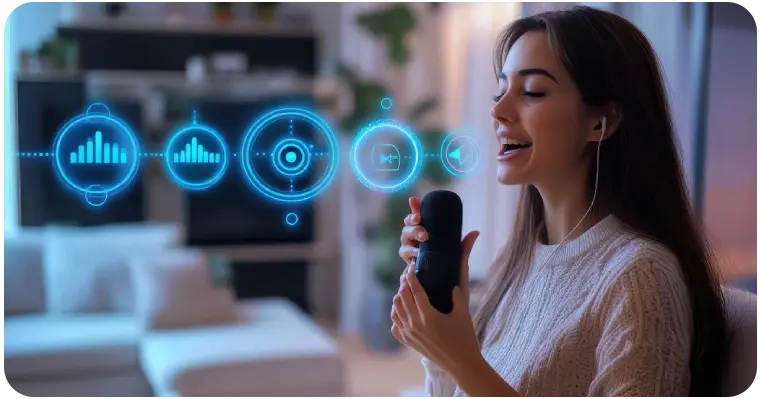
دستیارهای صوتی هوشمند امروزه به یکی از ابزارهای ضروری در زندگی روزمره تبدیل شدهاند. از سیر کردن در خانه گرفته تا مدیریت برنامههای کاری، این سیستمها با تشخیص صحیح صدای انسان و پردازش آن، تجربهای بینظیر را برای کاربران فراهم میکنند. اما چگونه این دستگاهها میتوانند صدای ما را تشخیص دهند؟ چه فرایندی پشت این فناوری پیچیده قرار دارد؟ در این مقاله به بررسی جزئیات مهم تشخیص صدا توسط دستیارهای هوشمند میپردازیم و به نکات کلیدی این فناوری مینگریم.
اصول پایه تشخیص صدا در دستیارهای هوشمند
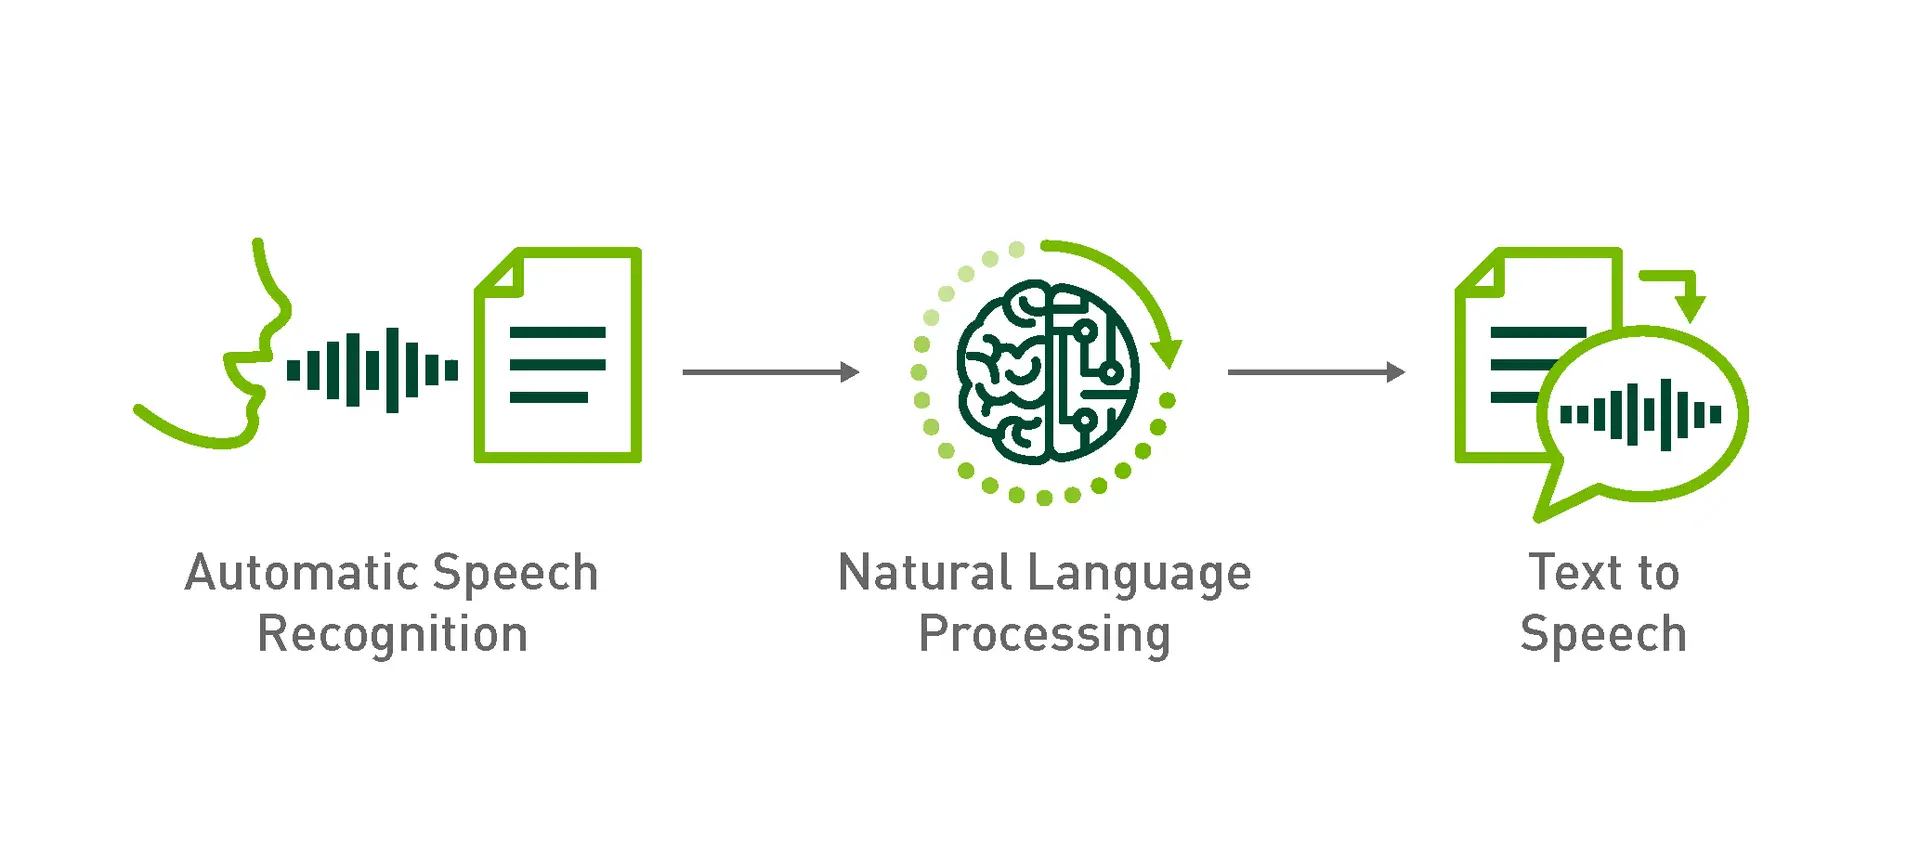
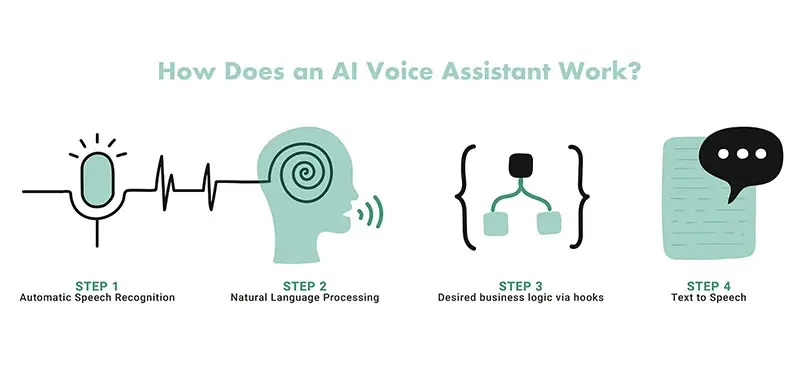
دستیارهای صوتی هوشمند مانند سیرا، الکسا یا گوگل اسستی با استفاده از الگوریتمهای پیشرفته و شبکههای عصبی مصنوعی، قادر به تشخیص و پردازش صدای انسان هستند. این فرآیند در چند مرحله اصلی انجام میشود:
- پیشپردازش صدا: زمانی که شما به دستگاه صحبت میکنید، میکروفون صدا را به سیگنال دیجیتال تبدیل میکند. این سیگنال سپس برای حذف نویزهای محیطی و تصحیح اشکالات فنی آمادهسازی میشود.
- تجزیه و تحلیل فرکانس: دستگاه با استفاده از تبدیل فوریه (FFT)، سیگنال صوتی را به اجزای فرکانسی تقسیم میکند تا بتواند صدا را به صورت موجهای مختلف تحلیل کند.
- شناخت الگوی صدا: شبکههای عصبی مصنوعی با آموزش بر روی میلیونها ساعت صدا، الگوی خاص هر کلمه یا جمله را شناسایی میکنند. این شبکهها قادرند حتی با وجود تفاوت در لحن یا سرعت گفتار، کلمات را تشخیص دهند.
- پردازش زبان طبیعی (NLP): پس از تشخیص کلمات، سیستم با استفاده از پردازش زبان طبیعی، معنای جمله را درک و پاسخ مناسب را تولید میکند.
این فرآیندها بهطور همزمان و با سرعت بسیار بالا انجام میشوند تا کاربر بتواند پاسخ بلافاصله دریافت کند.
چالشهای تشخیص صدا و راهکارهای حل آن
در حالی که دستیارهای صوتی هوشمند پیشرفتهای چشمگیری داشتهاند، هنوز با چالشهایی مانند:
- نویز محیطی (صدای پشتزمینه، موسیقی، صدای ترافیک)
- تفاوت در لحن و سرعت گفتار افراد مختلف
- کلمات مشابه یا همصدا (مانند “پنج” و “پنجاه”)
- اختلاف در لهجه و گویش
روبرو هستند. برای حل این مشکلات، شرکتهای تولیدکننده از تکنیکهای مختلفی مانند:
- استفاده از میکروفونهای چندگانه برای کاهش نویز
- آموزش شبکههای عصبی با دادههای متنوع از گویشهای مختلف
- استفاده از الگوریتمهای پیشبینی کننده برای تشخیص کلمات در شرایط نویز
- بهروزرسانی مداوم سیستمها با دادههای جدید
استفاده میکنند. این راهکارها باعث افزایش دقت تشخیص صدا در شرایط مختلف شدهاند.
دقت و محدودیتهای تشخیص صدا
دقت دستیارهای صوتی هوشمند به عوامل متعددی مانند:
- کیفیت میکروفون دستگاه
- شرایط محیطی (نویز، فاصله از دستگاه)
- کیفیت شبکه اینترنت (برای دستگاههای ابری)
- کیفیت آموزش دادههای شبکه عصبی
بستگی دارد. در شرایط ایدهآل، این دستگاهها میتوانند با دقت بالایی (بیش از ۹۰٪) کلمات را تشخیص دهند، اما در شرایط نویز یا گویشهای محلی، دقت ممکن است کاهش یابد.
یکی از محدودیتهای اصلی این سیستمها، وابستگی به اینترنت است. بسیاری از دستیارهای صوتی هوشمند برای پردازش صدا به سرورهای ابری نیاز دارند، که این موضوع میتواند در مناطق با اینترنت ضعیف یا در شرایط اضطراری، مشکلساز شود.
آینده تشخیص صدا در دستیارهای هوشمند
فناوری تشخیص صدا همچنان در حال پیشرفت است و تحقیقات جدید در زمینه:
- استفاده از هوش مصنوعی ژنراتیو برای تولید پاسخهای طبیعیتر
- بهبود تشخیص صدا در شرایط نویز بالا
- پردازش صدا در دستگاههای محلی (بدون نیاز به اینترنت)
- شناسایی احساسات و لحن گفتار برای پاسخهای شخصیتر
در جریان است. با پیشرفت این فناوریها، دستیارهای صوتی هوشمند قادر خواهند بود تجربهای بسیار شخصیتر و کارآمدتر را برای کاربران فراهم کنند.
اگر به جزئیات فنی بیشتر در مورد هوش مصنوعی و کاربردهای آن در زندگی روزمره علاقهمند هستید، میتوانید در دیلی ۲۴ مقالات مرتبط را مطالعه کنید.